GLM-5 引用图谱:六十三项证据的来路与作用
GLM-5 技术报告的源码书目库含 104 条候选记录,正文实际调用 63 个 citation key,最终 PDF 也渲染出 63 条参考文献。本页严格按 v2 PDF 的最终编号排列,每个编号只出现一次;候选库中没有进入正文的记录不计入报告证据。
这份书目并不等于六十三个不同工作:DeepSeek-V3.2 被两个 citation key 重复收录。它也不保证“引用对象”与“评测版本”完全相同:Vending-Bench 论文对应第一版,报告表格使用 Vending-Bench 2;SWE-smith 是数据生成论文,报告却用其 key 指向 SWE-bench Multilingual;Terminal-Bench 的书目入口早于报告采用的 2.0 协议。下面在保留报告原编号的同时修正这些语义边界。
家族事件可与 GLM 时间线对读;报告本身的结构、公式、表格与附录见 GLM-5 深读。
报告最终书目
- [1] System Card: Claude Opus 4.5:既是 frontier model 对比来源,也为 \(\tau^2\)-Bench Airline 的 domain fix 提供协议依据;它不是 GLM-5 训练方法来源。
- [2] QuaRot:支撑昇腾 W4A8 部署中的旋转式异常值抑制;报告没有据此证明所有低比特路径都无损。
- [3] Vending-Bench:定义长期经营模拟的第一版任务。GLM-5 表格实际报告 Vending-Bench 2,第二版协议应另查官方评测页。
- [4] SWE-rebench:用持续挖掘的新鲜 GitHub issue 检验软件工程 Agent 的时效泛化,缓解静态测试集长期暴露带来的污染疑虑。
- [5] LongBench v2:覆盖真实长文档、多文档、代码仓库和结构化数据,是 GLM-5 长上下文推理评测的一部分。
- [6] MCP-Atlas:在真实 MCP server 上测量工具发现、参数构造和多步调用,报告使用公开子集并另行指定 judge 与时限。
- [7] \(\tau^2\)-Bench:把用户和 Agent 都设为可行动主体,测量 dual-control 对话;不能与只有静态用户模拟器的工具评测互换。
- [8] Gemini 3 Pro Model Card:为闭源 frontier baseline 提供第一方口径;横向表格仍受 harness、预算和版本日期约束。
- [9] DeepSeek-V3.2:是 DeepSeek Sparse Attention 的直接来源,支撑 GLM-5 从 dense MLA 转向 learned top-\(k\) 历史访问的主线。
- [10] Nemotron-Math:提供数学长上下文蒸馏与多模式监督数据背景,进入 mixed-domain reasoning RL 的开放数据来源。
- [11] NExtLong:说明无需原生超长文档也可构造长程依赖;报告据此设计合成 long-context data,而非照搬其完整配方。
- [12] ByteScale:为超长序列的动态负载均衡与可变 context-parallel 分组提供系统背景。
- [13] Better & Faster LLMs via Multi-token Prediction:给出 MTP 的通用训练动机;GLM-5 进一步共享三步 MTP 参数,以约束草稿模型的参数与 KV 成本。
- [14] MiniLLM:是 reverse-KL 生成式蒸馏前身,报告用它解释最终 on-policy cross-stage distillation。报告书目把年份写成 2025,实际论文发表于 ICLR 2023。
- [15] Jet-Nemotron:为 attention pattern search 与 GDN 训练管线提供相邻方法;报告只在 9B 消融中搜索 SWA / full-attention 层型。
- [16] Chinese SimpleQA:把短答案事实性评测扩展到本地化中文知识,和英文 SimpleQA 是两个独立数据集。
- [17] RULER:测量模型的有效上下文而非声明窗口,既用于 attention pattern search,也用于长上下文对比。
- [18] EntropyLong:以 predictive uncertainty 组织长上下文训练样本,是 GLM-5 合成长程依赖的数据构造灵感之一。
- [19] SWE-bench:定义真实 GitHub issue resolution;报告评测的是人工复核的 Verified 子集,原始论文与子集版本不应混写。
- [20] Fast Inference from Transformers via Speculative Decoding:给出 draft-and-verify 的正确性与加速框架,GLM-5 的共享 MTP 层充当内生 draft model。
- [21] DataComp-LM:为 web data classifier 与数据筛选实验提供开放基线;其 arXiv 首次公开于 2024,报告书目按后续发表年份列为 2025。
- [22] The Tool Decathlon:用多类真实工具和长程任务评估 Agent,报告通过官方评测服务提交结果。
- [23] TACO:提供 topic-diverse algorithmic code generation 数据,进入 competitive-programming reasoning RL 的开放数据池。
- [24] DeepSeek-V2:建立 MLA 与稀疏 MoE 的直接架构背景;GLM-5 保留 MLA 的 KV 压缩思想,但调整 head 维度并叠加 DSA。
- [25] DeepSeek-V3:提供 MTP 与 MoE 训练的家族前身,也是 GLM-5 比较草稿接受长度和系统取舍的重要基线。
- [26] DeepSeek-V3.2:与前面的同名条目是同一工作,源自两个不同 citation key;此处主要支撑 efficient-attention 对比、context management 与评测 baseline。
- [27] RepoQA:测量 repository-level 长上下文代码理解,进入 9B attention 消融而非最终 Agent coding 主表。
- [28] On-Policy Distillation:student 从自身 rollout 分布采样,再匹配 teacher 的完整分布;这是 GLM-5 跨阶段能力恢复的核心方法背景。
- [29] Towards Robust Mathematical Reasoning:提供 IMO-AnswerBench 及稳健数学答案评测语境,支撑最终数学能力表格。
- [30] AIMO-2 Winning Solution:提供 OpenMathReasoning 数据与竞赛数学训练经验,进入 mixed-domain reasoning RL 的开放数据来源。
- [31] Megatron-LM:为 interleaved pipeline parallelism 和大规模 GPU 训练布局提供基础;GLM-5 在此上重新放置 MTP 模块以平衡 stage memory。
- [32] Introducing GPT-5.2:既是评测对比对象,也被报告列为 difficulty filtering 的强 teacher;公开页面无法验证 GLM 内部 teacher 调用细节。
- [33] GDPval:定义经济价值任务;报告展示的是 GDPval-AA Elo,且明确记录了榜单截面日期。
- [34] Humanity's Last Exam:提供跨学科 frontier knowledge / reasoning 测量;报告中星号结果还区分 text-only 与 full set。
- [35] SYNTHETIC-2:提供公开协作生成的 reasoning trace,进入代码 RL 数据来源;博客发布说明不等于数据质量的独立复现。
- [36] Generalizing Verifiable Instruction Following:对应 IF-Bench,以可程序验证的约束测量指令遵循,和开放式 style judge 分开。
- [37] Zero Bubble Pipeline Parallelism:通过推迟部分 weight-gradient computation 减少 pipeline bubble;GLM-5 把这一思路接到自己的存储与通信重叠设计。
- [38] ZeRO:为 optimizer、gradient 与 parameter sharding 提供基础;报告重点使用 pipeline rank 内的 ZeRO-2 gradient sharding。
- [39] GPQA:以研究生级、难检索科学问题测量推理,主表使用 Diamond 子集。
- [40] DeepSeekMath:是 GRPO 的直接方法来源,构成 GLM-5 reasoning RL 的起点;实际配方还加入 IcePop 并移除 KL regularization。
- [41] MultiChallenge:测量多轮对话中的指令保持、上下文分配与 in-context reasoning,进入通用能力附录。
- [42] Harbor:定义可执行 terminal-agent task 的容器格式;报告用 construction / refine agents 合成并校验这类环境。
- [43] Kimi K2.5:作为同时期 agentic frontier model 进入综合对比,不是 GLM-5 架构或训练数据来源。
- [44] Every Step Evolves:提供 trillion-scale thinking model 的 RL 背景;报告把 agentic token-ratio masking 与其 IcePop 式校准作邻近比较。
- [45] Terminal-Bench:是终端 Agent benchmark 的项目入口。报告实际采用 2.0 及一个修订歧义指令的 verified 版本,不能只按早期仓库题名解释。
- [46] MENT:构造非字面英中翻译评测,报告使用其中 SNS 等四个领域检查语言与文化鲁棒性。
- [47] FlexSP:为长序列训练中的灵活 sequence parallelism 提供系统基础,与 ByteScale 一起解释动态计算重分配。
- [48] CyberGym:在真实漏洞环境中测量安全修复 Agent;它评估执行能力,不等于模型经过完整安全审计。
- [49] SimpleQA:测量单一、可判定短答案的事实性。源码引用 key 与书目 key 的大小写不一致,最终渲染条目实际对应这项工作。
- [50] BrowseComp:测量网页检索、证据聚合和长程搜索;报告强调其结果对 judge prompt 与 judge model 敏感。
- [51] MiMo-V2-Flash:为 on-policy distillation 和 reasoning post-training 提供同时期实现背景。
- [52] Qwen3:支撑 thinking / non-thinking 统一与蒸馏的相邻路线,报告在跨阶段 on-policy distillation 处引用。
- [53] SWE-smith:论文主题是可扩展的软件工程训练数据生成;SWE-bench Multilingual 官方页要求引用该记录,但不能把题名改写成一篇专门提出 Multilingual benchmark 的论文。
- [54] Gated Delta Networks:是 9B efficient-attention 消融中的线性注意力候选;GLM-5 最终主干并未采用 GDN。
- [55] \(\tau\)-Bench:定义 tool-agent-user interaction 的前代基准,与后续 dual-control 的 \(\tau^2\)-Bench 共同构成工具对话评测谱系。
- [56] HELMET:提供更完整的长上下文评测设计;报告在 9B 消融中使用其 ICL 子任务。
- [57] DAPO:为 token-level policy-gradient loss 和大规模 reasoning RL 提供基础,报告在 artifact generation 的稳定化处引用。
- [58] Efficient Activation Rematerialization and Optimal Hybrid Parallelism:支撑 pipeline warmup 中按层 offload / reload activation 的设计,并与细粒度 recomputation 配合降低峰值显存。
- [59] SWE-bench Goes Live:其 RepoLaunch pipeline 启发从 issue–PR 对自动构建可执行环境、测试命令与日志解析器。
- [60] Insights into DeepSeek-V3:从硬件 roofline 解释 MLA head 配置;GLM-5 据此重新权衡 training / prefill 与 decode 的维度成本。
- [61] IcePop:针对 MoE RL 的 training–inference mismatch;GLM-5 reasoning RL 采用其校准思想,但明确移除 KL regularization。
- [62] Group Sequence Policy Optimization:以 routing replay 保持 MoE top-\(k\) expert 一致。GLM-5 借这个类比说明 DSA top-\(k\) 一致性的重要性,但没有采用完整 index replay:\(k=2048\) 的索引存储与通信代价过高,实际方案是冻结 indexer,并在 rollout 与训练两端使用 deterministic
torch.topk。 - [63] BrowseComp-ZH:扩展中文网页浏览能力测量,与英文 BrowseComp 共同构成 search-agent 主表。
七条主链
| 主链 | 报告吸收的历史节点 | GLM-5 中的落点 |
|---|---|---|
| 稀疏注意力 | MLA → DSA | 先由 indexer 选择历史 token,再执行 top-\(k\) attention;冻结 indexer,并以 deterministic torch.topk 保持 rollout / training 一致,而不是回放完整索引 |
| 多 token 解码 | MTP → speculative decoding | 三个训练步共享参数,MTP 同时增加预训练信号并充当 draft model |
| 长上下文数据 | DataComp-LM、NExtLong、EntropyLong | web 质量分类、自然长文档与合成长程依赖共同进入 128K / 200K mid-training |
| 分布式训练 | Megatron-LM、ZeRO、Zero Bubble、ByteScale、FlexSP | MTP stage placement、gradient sharding、activation offload、deferred gradient 与动态 context parallel 合流 |
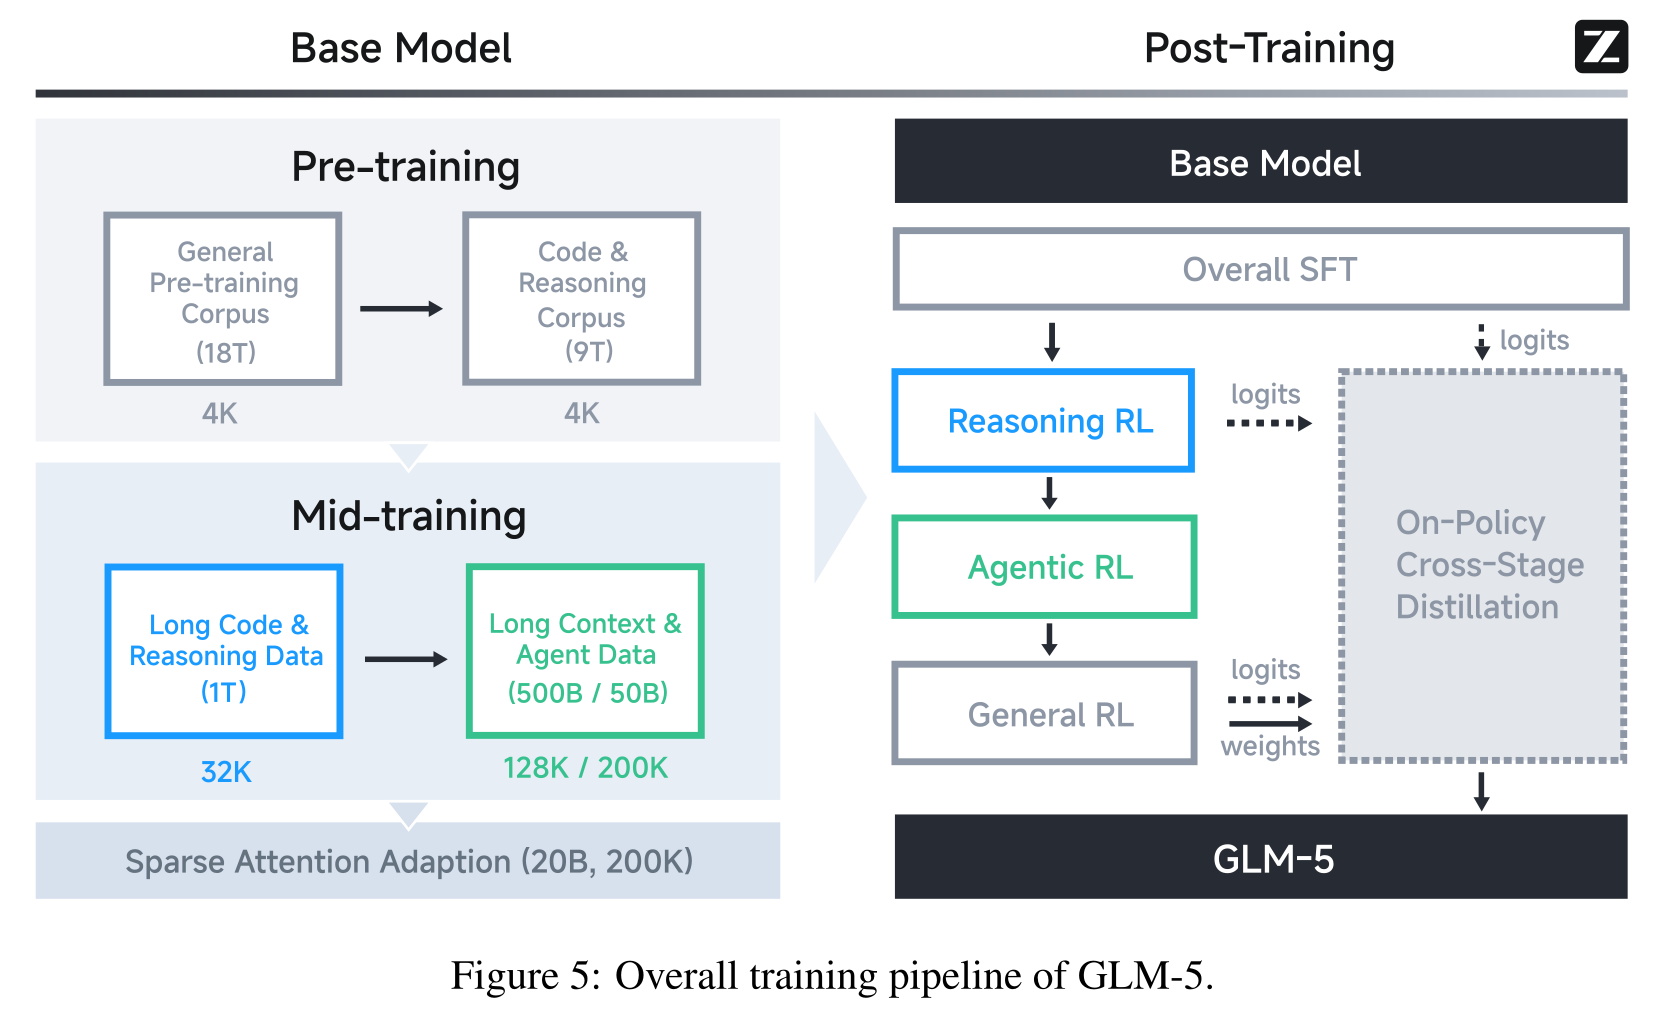
| reasoning RL | DeepSeekMath → IcePop | GRPO 家族目标处理数学、科学、代码和 tool-integrated reasoning,并校准 rollout / training mismatch |
| Agentic RL | SWE-bench Goes Live、Harbor、DAPO | 可执行环境、长轨迹、token-level loss 与 outcome 分批共同服务 coding、terminal、search 和 artifact tasks |
| 能力合并 | MiniLLM → On-Policy Distillation | 最终 checkpoint 从自身 rollout 采样,再向多个阶段 teacher 的分布恢复早期能力 |
这些箭头表示报告可以核对的前身与组合关系。GLM-5 自身的具体超参数、数据比例、内部 judge 和私有 prompt set 仍应优先引用报告,而不能归因给任一前置工作。
报告之后的一跳来源
下面的节点不属于报告最终书目,只用于解释发布后的 5.x 演化、修正 benchmark 版本,或连接公开实现。它们不参与上面的编号。
- GLM-5 official repository:权重、部署命令、推理框架适配与后续 5.1 入口。
- GLM-5 official model card:公开 checkpoint 配置与许可证的可核对对象。
- GLM-5.1 official model card:报告之后的长程 Agent checkpoint;仍引用 GLM-5 家族报告。
- GLM-5.2 technical blog:披露 1M context、IndexShare、MTP 更新、服务优化与后训练变化。
- GLM-5.2 official model card:权重、配置、部署与 MIT 许可入口。
- IndexCache:围绕 DSA index 复用与长上下文推理成本的报告后一跳工作。
- Bebop:GLM-5.2 博客明确引用的推测解码研究,连接 rejection sampling 与 MTP 接受率。
- Single-Rollout Asynchronous Optimization:处理长程 Agent rollout 的异步稳定性,属于 5.2 后训练的后续公开工作。
- CompactionRL:把 context compaction 纳入长程 Agent 强化学习,解释轨迹被拆成不等长子轨迹后的优化问题。
- slime:GLM 家族 Agentic RL 的公开训练—rollout 基础设施入口。
- SWE-bench Multilingual official benchmark:定义 300 个任务、42 个仓库和 9 种语言,并解释为什么官方 citation 指向 SWE-smith。
- SWE-bench Verified:人工复核子集的官方说明,与原始 SWE-bench 论文分层。
- Vending-Bench 2 official evaluation:报告表格所用第二版任务与独立运行方入口。
- Terminal-Bench 2.0:报告采用版本的正式说明,区别于最终书目中的早期项目入口。
- SimpleQA official release:数据、grader 与 correct / incorrect / not-attempted 语义的第一方说明。
证据边界
- 层数存在内部冲突。正文写 80 层,超参数附录写 3 个 dense layer 加 75 个 MoE layer,公开配置也给出 78 层。应保留冲突,不用算术替作者选择版本。
- Agentic RL 的开场公式不能直接执行。该式未显式包含 policy ratio 或 log-prob;若只把组内中心化 reward 相加,目标恒为零。后文的 rollout-ratio、双侧 masking 与 token loss 才提供可训练线索,但仍不足以复原完整实现。
- 实验口径不是统一常数。HLE 有 text-only / full-set 区分,Terminal-Bench 有原版与 verified 任务,GDPval-AA 是带日期的 Elo 截面,BrowseComp 依赖 proprietary judge,MTP 接受长度使用 private prompt set。
- 模型对比不等于同条件复现。闭源模型的系统卡、官方分数和 GLM 团队重跑结果应分开标注;context、max tokens、thinking effort、工具、sampling 与 harness 任一变化都可能改变结论。
- 书目映射需要人工校正。SimpleQA 的 key 大小写不一致;SWE-bench Multilingual、Vending-Bench 2、Terminal-Bench 2.0 的实际版本与最终书目题名并不一一对应;MiniLLM 年份错误;DeepSeek-V3.2 重复出现。
- 报告后工作不能倒灌。GLM-5.1、GLM-5.2、IndexCache、Bebop、SAO 与 CompactionRL 能解释后续演化,但不能被写成 2 月版 GLM-5 报告已经采用或引用。
- 作者报告值仍需外部复现。数据规模、内部环境数量、国产硬件吞吐、私有评测和 serving efficiency 可以作为第一方披露引用,不能改写成独立验证事实。