Kimi 技术谱系:从长推理到三万亿级开放权重
先用 Kimi 家族总览区分 checkpoint、机制研究、训练与推理系统、Agent 工具和评测产物;本页沿时间解释这些分支为何出现、在哪里汇合。
Kimi 家族不是一条只按参数量递增的直线。Kimi k1.5 把长上下文强化学习推到前台,Kimi-VL 建立视觉分支,Kimi K2 把稀疏模型与 agentic post-training 结合,Kimi Linear 改写长序列的信息通路,Kimi K2.5 让视觉、thinking 与 agent 共同训练,Attention Residuals 又把寻址能力从 token 轴延伸到 depth 轴。Kimi K3 才把这些路线汇合成同一个 2.8T 级系统。
这条历史必须同时记录六种对象:
它们经常不同步。论文公开不代表权重已经可下载,仓库存在不代表训练代码已发布,API 中的同名模型也不必等于某个公开 checkpoint。K3 的结构、训练与系统细节可继续读工作深读,报告全部引用及其归因边界见引用图谱,多模态分支则集中在 Kimi 多模态家族。
一张先区分对象的时间线
| 节点 | 首次可核验的论文或报告日期 | 权重 | 代码 | API / 产品 | 许可证 |
|---|---|---|---|---|---|
| Kimi k1.5 | 2025-01-22,arXiv:2501.12599 | 未随官方报告仓库发布 | 仓库只有报告、README 与图片 | 论文不能证明某个同名线上服务等同于该 checkpoint | 官方仓库没有模型许可证文件 |
| Kimi-VL | 2025-04-10,arXiv:2504.07491 | A3B-Instruct 与后续 Thinking 版本 | 官方仓库含使用入口,不等于完整训练栈 | 官方曾提供体验入口;具体线上版本应单独核验 | MIT |
| Kimi K2 | 2025-07-28,arXiv:2507.20534 | K2-Instruct;报告也区分 Base / Instruct | 报告仓库与推理适配;训练配方未完整开放 | API / 产品是独立发布面,不能由 arXiv 日期倒推 | Modified MIT |
| Kimi Linear | 2025-10-30,arXiv:2510.26692 | 48B-A3B Base 与 Instruct | FLA 中的 KDA 与官方仓库 | 研究模型发布,不应自动写成独立商业 API | MIT |
| Kimi K2.5 | 2026-02-02,arXiv:2602.02276 | K2.5 | 报告与部署资料,未开放完整预训练和 RL 系统 | 产品中的 thinking、visual agent 与 Agent Swarm 属于线上系统层 | Modified MIT |
| Attention Residuals | 2026-03-16,arXiv:2603.15031 | 无独立 checkpoint | 官方仓库当前主要包含论文与图表,不应写成完整 reference implementation | 无独立 API | 仓库未提供单独许可证文件 |
| FlashKDA | 2026-04 的官方实现与设计资料;不是单独的模型报告 | 无模型权重 | MIT 代码 | 无独立 API | MIT |
| Kimi K3 | 2026-07-16 发布文章;2026-07-27 技术报告 | 2.8T / 104B activated checkpoint | 报告仓库、FlashKDA、MoonEP 等分散组件;不是完整训练栈 | 平台列出 kimi-k3;API 行为还受服务端版本、effort 与缓存策略影响 |
Kimi K3 License,不是 MIT / Apache-2.0 |
表中日期只指对应公开物的首次可核验版本。仓库创建时间、arXiv 首次提交、博客发布、模型库上传和 API 上线可以不同;若没有一手记录,就保留“未确认”,不拿邻近日期填空。
2025-01:K1.5 先把 RL 的长度轴打开
Kimi k1.5 的历史位置,不在于它给出了后来 K3 的全部优化算法,而在于它把三件事绑到了一起:
- 长 chain-of-thought 不再只是 inference trick,而成为强化学习中的可扩展行为;
- rollout 长度与 context window 一起扩展,报告把 RL context 推到 128K;
- partial rollout 用已完成轨迹推进训练,降低长尾样本形成的同步屏障。
这条线后来进入 K2.5,再被 K3 扩展为跨 iteration 保存轨迹、KV state 与 sandbox state 的百万 token agentic RL。需要注意,K1.5 官方仓库只公开报告和说明材料;没有权重或完整训练代码时,不能把“方法公开”写成“系统可复现”。
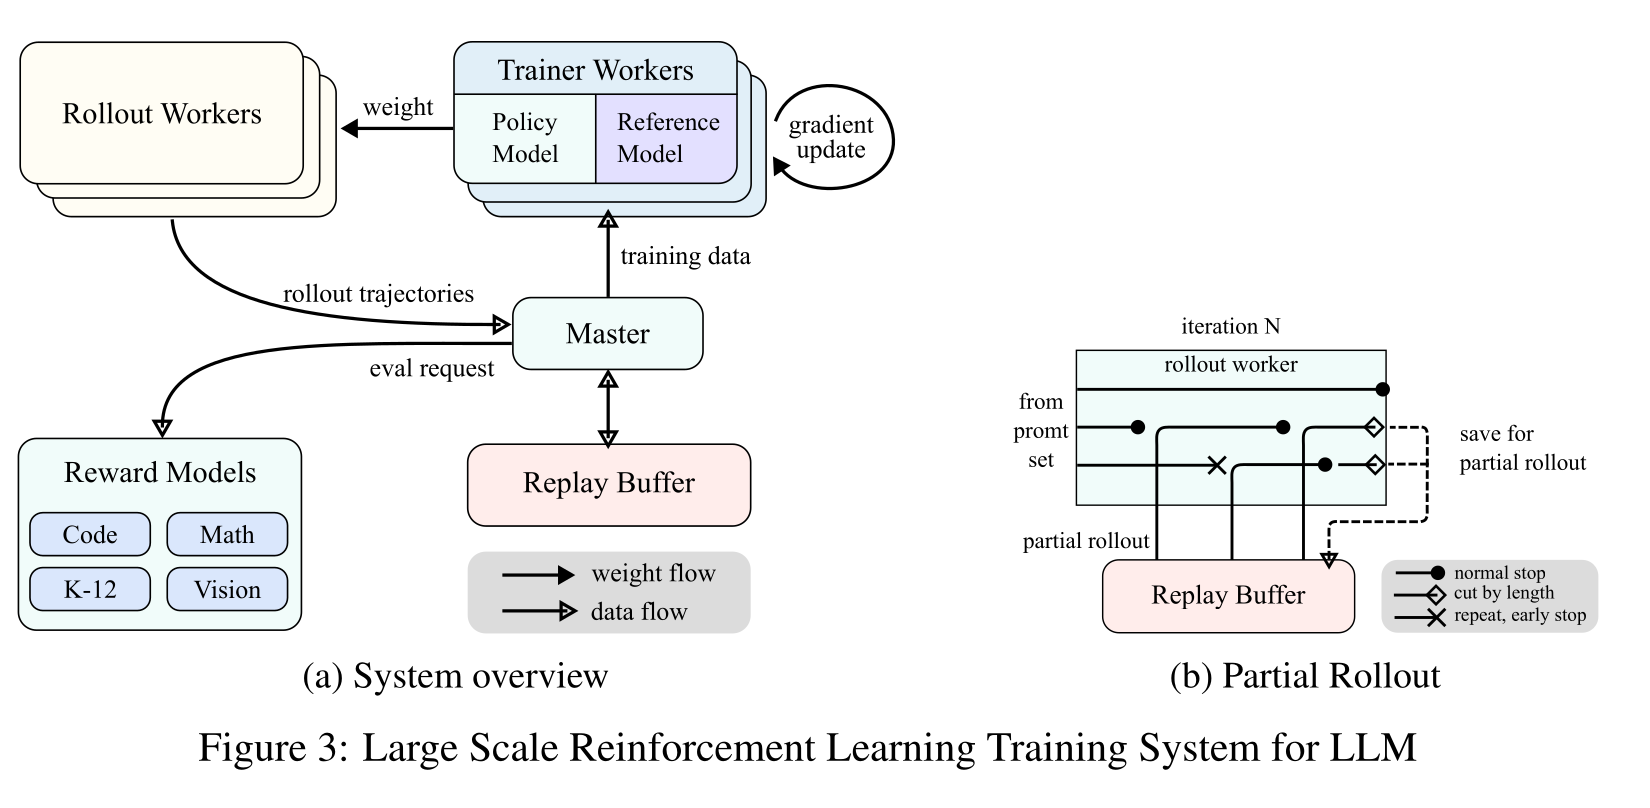
K1.5 也建立了 Kimi 家族中持续出现的一种研究习惯:把结果同时放在数学 / 视觉推理、长 CoT 和 policy optimization 下观察,而不是只以短答案准确率评价 reasoning。它与推理策略优化谱系相接,却不等同于后来的 DAPO、VAPO 或异步 SAO。
2025-04:Kimi-VL 建立独立的视觉分支
Kimi-VL 使用稀疏视觉语言模型研究视觉编码、长文档、视频与多模态 reasoning。它与 K3 的关系主要有两层:
- 模型家族经验:视觉 token 如何进入 MoE language backbone,以及视觉 instruction / reasoning 数据怎样组织;
- 评测与训练经验:长视频、文档、多图和 visual agent 需要不同于静态 VQA 的上下文与工具接口。
K3 使用新的 MoonViT-V2,并称其从 next-token prediction 目标直接训练;这不能被简化为“沿用 Kimi-VL encoder”。Kimi-VL 是技术谱系,MoonViT-V2 的具体结构与训练主张仍应引用 K3 报告本身。
Kimi-VL 的权重和使用代码采用 MIT 许可证。权重开放、推理代码可运行与训练数据 / 训练系统开放仍是三种不同层级,详见开放模型生态。
2025-07:K2 把 1T MoE、MuonClip 与 agentic post-training 合起来
Kimi K2 是 K3 最直接的 dense-to-sparse scale baseline。它公开的主线包括:
- 1T 总参数、32B activated 的 MoE;
- 15.5T token 预训练;
- 从 Muon 发展出的 MuonClip,以 QK-clip 处理大规模训练不稳定;
- agentic data synthesis、工具环境和联合强化学习;
- Base 与 Instruct 的角色分离。
K3 报告中的约 \(2.5\times\) overall scaling-efficiency 改善,是相对 K2 family scaling curve 的整体拟合结果。它同时包含 KDA、Attention Residuals、Stable LatentMoE、激活、路由、数据和训练配方变化,不能拆成某个组件的独立倍数。
K2 的 Modified MIT License 与 K3 的自定义许可证不同。模型家族名称相近不意味着开放条件保持不变;部署前应总是回到具体 checkpoint 的许可证。
2025-10:Kimi Linear 把序列状态从理论变成可扩展模型
Kimi Linear 从 Gated DeltaNet 出发,引入带逐 key-channel forget gate 的 Kimi Delta Attention(KDA),并把三层 KDA 与一层全局 MLA 交错。它回答了 K3 之前的三个问题:
- 线性递推能否保持比普通 linear attention 更强的 associative update;
- recurrent form 与 chunkwise parallel form 能否在同一算子中数值对应;
- 固定大小状态带来的 decode / KV 优势,是否能在短上下文能力上不明显退让。
K3 沿用 3:1 hybrid pattern,却不是把 48B Kimi Linear 机械放大:它修改 decay parameterization,加入 Gated MLA、Block AttnRes、Stable LatentMoE 与新的系统路径。KDA 的历史与最小递推见状态空间与线性注意力,K3 的完整实现约束见工作深读。
Kimi Linear 同时公开 Base / Instruct 权重与 FLA kernel,许可证为 MIT;这使 KDA 的一部分可独立验证。K3 的 FlashKDA、KDA Context Parallelism 与 state-aware prefix cache 则属于后续系统层。
2026-02:K2.5 让视觉、thinking 和 Agent Swarm 共同训练
Kimi K2.5 在 K2-Base 上继续约 15T mixed visual-text token 的 continual pretraining,并把 instant / thinking、视觉输入和 agentic execution 放入同一模型。它给 K3 留下四条直接接口:
- 原生视觉不再是独立 adapter 的附属能力;
- RL 同时覆盖 text 与 vision;
- reasoning effort 需要进入训练条件,而不只是线上 token cap;
- partial rollout 与 per-token regularization 可以承受长轨迹的 policy staleness。
Agent Swarm 是 K2.5 的系统能力分支:模型动态拆解任务并发出多个 agent。K3 的报告重点转向统一 white-box harness、长程 persistent environment、百万 token rollout 和 verifier-in-the-loop,不应把两个系统名称混成同一训练方法。
K2.5 checkpoint 使用 Modified MIT License。其产品能力、API harness 和公开权重的本地推理能力仍需分开报告,尤其是 agent 数量、tool 权限、context management 与并发调度。
2026-03:Attention Residuals 打开 depth 轴
标准 residual 把所有早期输出以固定单位权重累积到一个 residual stream。Attention Residuals 用 layer-specific pseudo-query 对历史层表示做内容相关的 softmax aggregation,把 attention 的“选择性读取”从 token 轴延伸到 depth 轴。
Full AttnRes 需要保留所有前层表示;Block AttnRes 把层分块,只在 block summaries 上做跨深度 attention,从而把额外 live state 与 pipeline communication 压到 \(O(Nd)\)。K3 采用 8 个 block,并让 speculative draft 从不同 block 深度抽取特征。
这一支与 DenseFormer、Hyper-Connections、MUDDFormer 和 mHC 都在处理跨层信息流,但计算对象不同。AttnRes 的官方仓库当前主要公开论文与图表;在 reference implementation 缺席时,页面中的教学代码只能标为按公式重建,不能冒充作者代码。
2026-04 至 07:kernel 与 expert parallel 先后接住模型结构
FlashKDA 把 KDA 的 chunkwise algebra 落到 CUTLASS kernel,并接入 FLA backend。它说明“序列复杂度线性”还不足以形成高性能实现:tile 内 decay、recurrent state、数值范围和 memory movement 都必须共同设计。
MoonEP 则为极稀疏 MoE 引入 dynamic redundant experts。它先根据实际路由规划复制哪些远端专家,再让每个 rank 执行固定数量 token,以避免 hottest rank 决定整层尾延迟。MoonEP 是 K3 报告正文和附录的重要贡献,却没有出现在报告 150 项 bibliography 中,因此引用时应直接链向 K3 报告和 MoonEP 仓库。
两者均为 MIT 代码;K3 权重本身则使用 Kimi K3 License。组件许可证不能替代模型许可证。
2026-07:K3 汇合三条信息流
K3 把架构组织成三个互补维度:
- sequence:69 层 KDA 与 24 层 Gated MLA;
- depth:8 个 Block AttnRes block;
- channel:896 routed experts 中每 token 选择 16 个,并保留 2 个 shared experts。
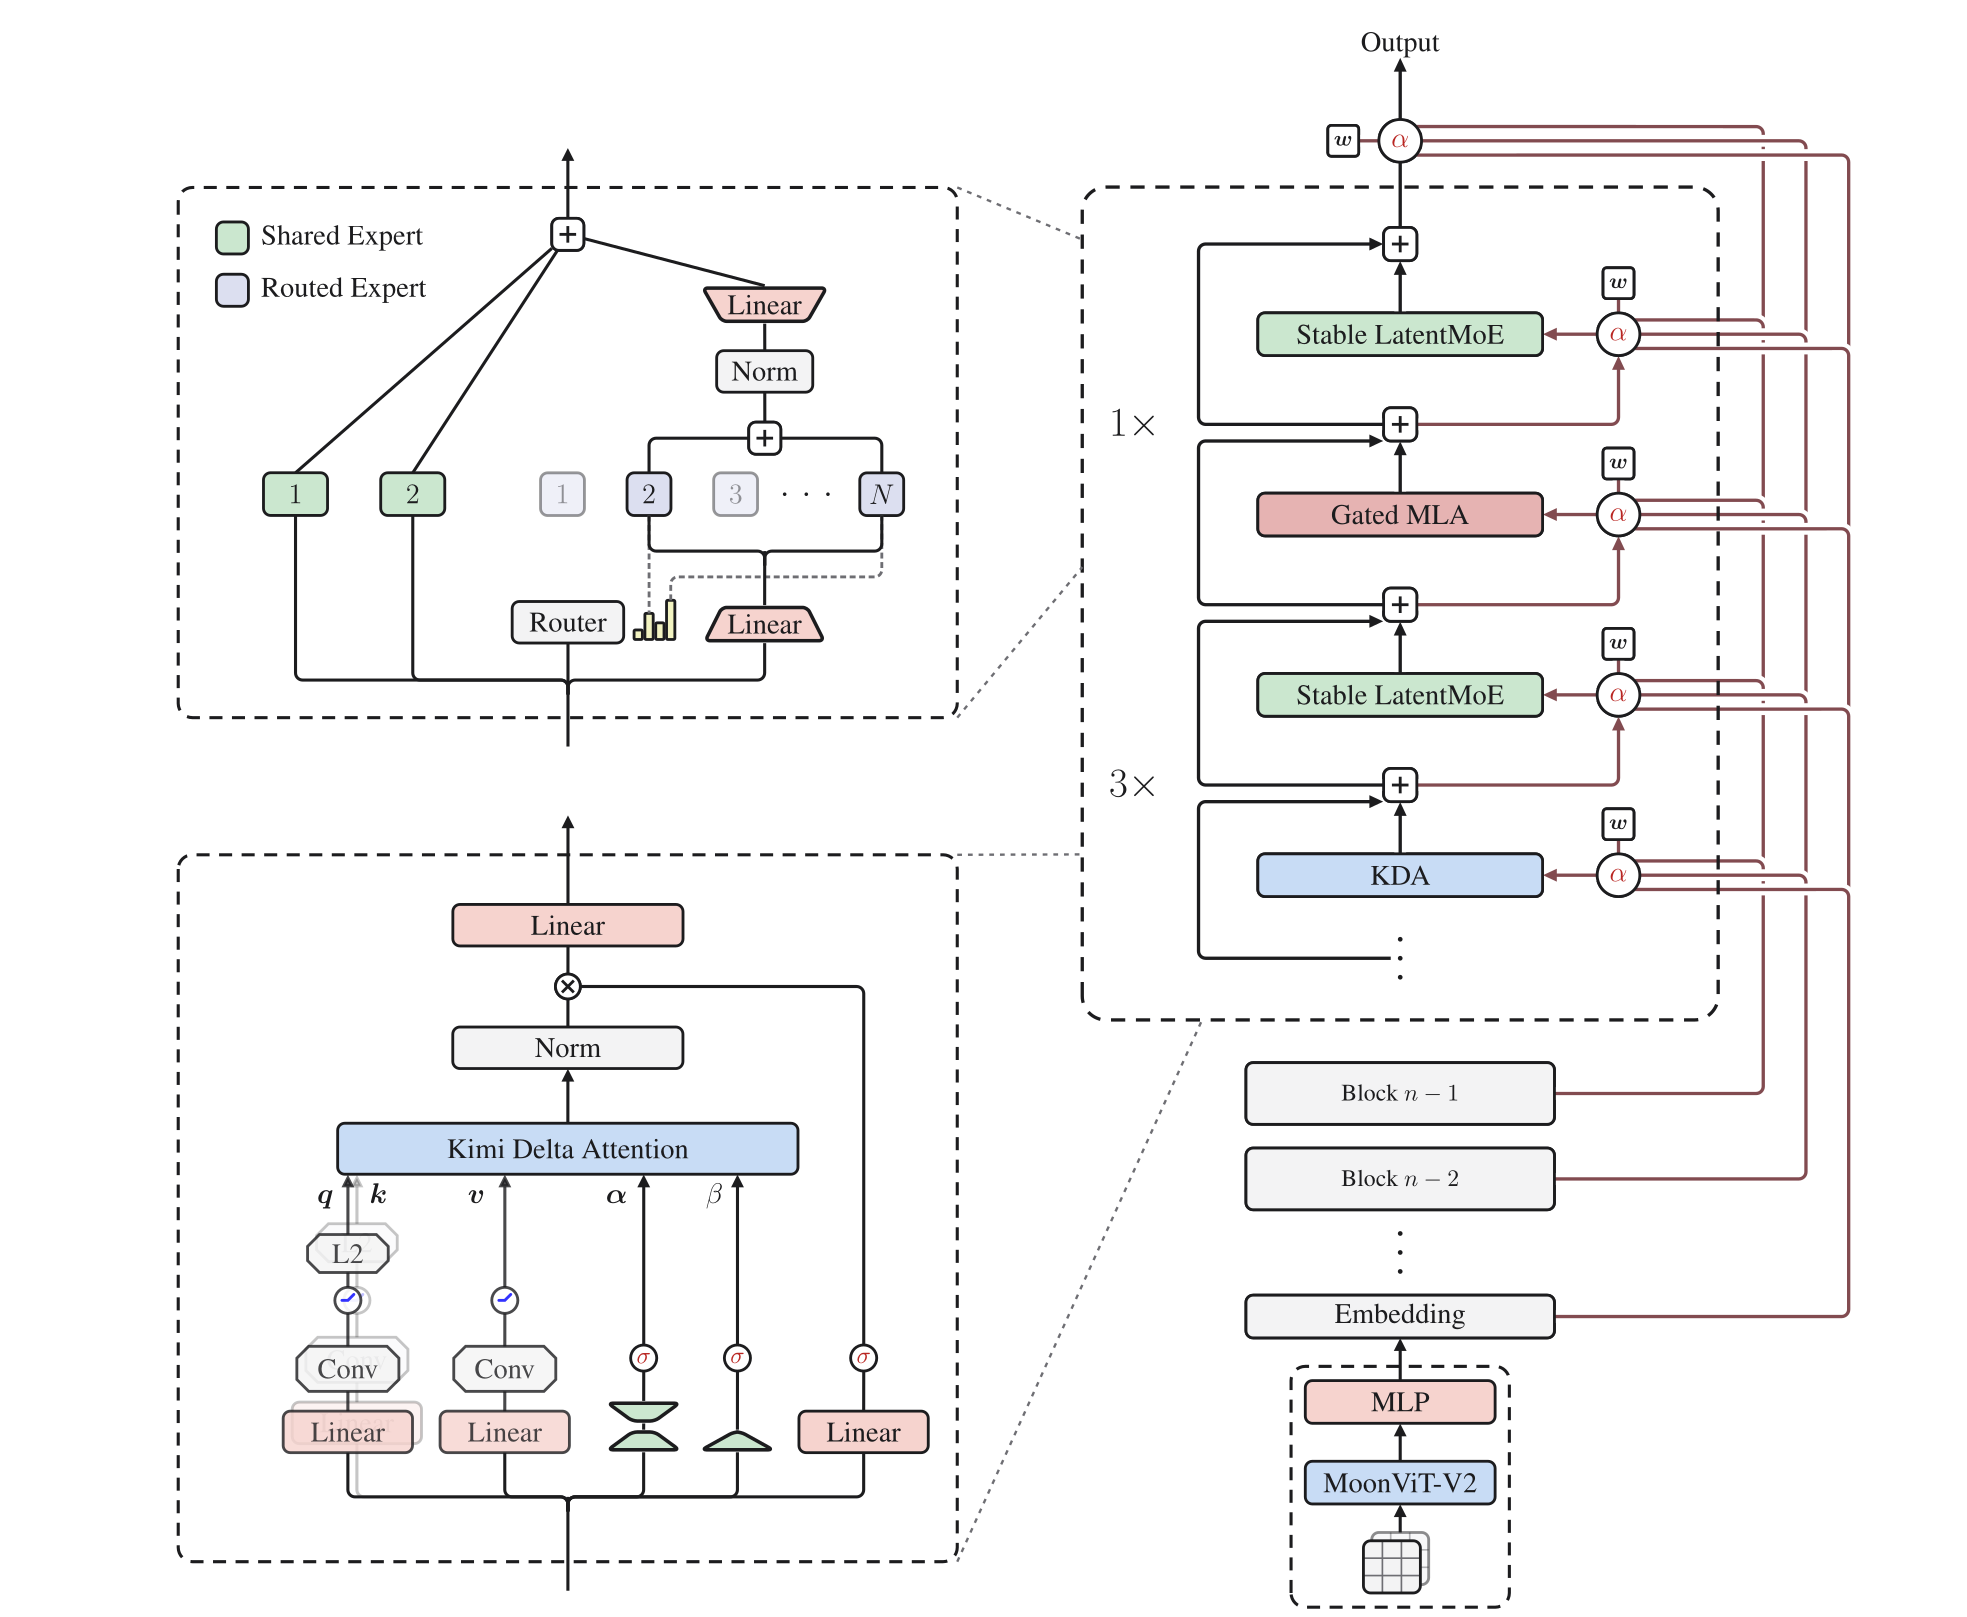
原生视觉、Per-Head Muon、逐级 1M context curriculum、九个 domain × effort RL experts、Multi-Teacher On-Policy Distillation,以及 MoonEP / persistent sandbox / hybrid prefix cache 共同构成训练与部署闭环。只复制任一公式都无法推出报告中的整体结果。
K3 有三个相邻但不同的公开节点:
- 2026-07-16 发布文章给出产品叙事与能力概览;
- 2026-07-27 技术报告给出结构、训练、系统、评测与 150 项 bibliography;
- 模型卡与权重给出机器可读 config、checkpoint shard 与部署入口。
官方 API 当前提供 kimi-k3 并暴露 reasoning_effort。API 请求的实际行为仍取决于服务端版本、preserved-thinking history、工具模板、缓存和安全策略;它不是“远程读取公开 safetensors”的同义词。
Kimi K3 License 允许使用、修改、分发和商业部署,但包含特定 Model-as-a-Service 与超大规模产品条件。准确描述应是 open-weight under the Kimi K3 License,而不是把它自动归入 MIT、Apache-2.0 或 OSI 软件许可证。
哪些关系是继承,哪些是 K3 新增
| 机制 | 可追溯前身 | K3 中新增或重新组合的部分 |
|---|---|---|
| KDA | Gated DeltaNet、Kimi Linear | lower-bounded decay、大规模 FlashKDA、KDA Context Parallelism、prefix-state cache |
| MLA | DeepSeek-V2 MLA、Kimi Linear hybrid attention | Gated MLA、NoPE 配置、与 AttnRes / KDA 的共同系统路径 |
| depth mixing | ResNet、DenseFormer、Hyper-Connections | Block AttnRes 进入 93-layer K3,并与 pipeline / EAGLE draft 特征相连 |
| MoE | Switch、GShard、DeepSeekMoE、LatentMoE | Normalized LatentMoE、SiTU-GLU、16/896、Quantile Balancing、MoonEP |
| optimizer | Muon、Scalable Muon、K2 MuonClip | Per-Head Muon |
| multimodal | Kimi-VL、K2.5 | 从头 NTP 训练的 MoonViT-V2 与 3T backbone 联合训练 |
| RL | K1.5 partial rollout、K2 / K2.5 agentic RL | 3 domains × 3 efforts、百万 token persistent rollout、MOPD consolidation |
| serving | Mooncake、speculative decoding | KDA / MLA hybrid prefix cache、recurrent-state-aware draft verification |
| protocol | 常规 chat template、Harmony channels | XTML option lifecycle、typed parallel tool calls、preserved thinking contract |
Stable LatentMoE、SiTU-GLU、Quantile Balancing、Per-Head Muon、MoonViT-V2、MoonEP、XTML 等名称都应以 K3 报告为直接来源。相关背景只能解释它们接住了什么问题,不能反向宣称 K3 采用了未在报告中出现的方法。
怎样阅读这条家族线
- 想理解 K3 本身:先读工作深读,再以引用图谱向前追溯。
- 想理解视觉分支:先读 Kimi-VL,再由 Kimi 多模态家族进入 K2.5 与 MoonViT-V2。
- 想理解线性状态:读线性注意力与状态空间谱系和状态空间与线性注意力。
- 想理解稀疏宽度:读条件计算谱系和 Mixture of Experts。
- 想理解长程 RL:读推理策略优化与 Agentic RL 训练系统。
- 想比较开放程度:按 paper、weights、code、data、API、license 六列回到开放模型生态。
Reference
- Kimi k1.5: Scaling Reinforcement Learning with LLMs
- Kimi-VL Technical Report
- Kimi K2: Open Agentic Intelligence
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Kimi K2.5: Visual Agentic Intelligence
- Attention Residuals
- Kimi K3 official technical report
- Kimi K3 model card and weights
- MoonshotAI/FlashKDA
- MoonshotAI/MoonEP