多模态的四条汇流
今天的多模态模型看起来像一棵枝叶繁密的大树:有的负责读图,有的生成声音,有的预测下一帧,有的直接控制机器人。若只按模型名称记忆,很快会被版本淹没;更稳定的理解方式,是追踪四条原本相对独立、后来逐步汇合的技术水流:
- 感知:把连续信号变成可计算的表示;
- 语义对齐:让图像、声音、视频与语言进入可比较的空间;
- 可逆生成:从紧凑表示重新合成像素、波形与运动;
- 环境交互:用观察预测未来,并把预测转化为动作。
这四条路线并非依次替代。一个现代系统往往同时包含感知 encoder、语言主干、媒体 tokenizer、生成 decoder、记忆与控制器;所谓“原生”或“统一”,只有落到这些接口怎样训练和共享参数上才有意义。
第一条水流:从手工特征到可学习感知
早期视觉和语音系统通常把表示设计与任务学习分开:视觉依赖边缘、角点和局部描述子,语音依赖频谱、声学模型与语言模型。它们建立了两个至今仍然重要的观念:
- 原始信号必须先被采样和压缩;
- 不同不变性需要不同归纳偏置,例如平移、局部时间连续性和尺度变化。
LeNet 展示了卷积、共享权重与端到端梯度训练如何结合;AlexNet 则把大数据、GPU 与深层卷积网络推到同一条扩展曲线上。随后,检测与分割把“这是什么”推进到“它在哪里”,为后来的 grounding 留下坐标、区域和密集预测接口。
语音侧经历了相似变化。频谱仍是有效的信号坐标系,但表示逐渐由模型从波形中学习。wav2vec 2.0 和 HuBERT 通过遮蔽预测与离散伪标签,从大量无标注语音中学习上下文表示。这里产生的表示适合识别,却未必足以重建音色和相位;“理解表示”和“生成表示”从一开始就不是同一个目标。
Transformer 把这种演进带到视觉和视频。Vision Transformer 把图像切成 patch 序列,TimeSformer 与 VideoMAE 继续处理时空 token。统一的序列接口降低了跨模态架构复用成本,却没有消除采样率、二维几何和时间别名等模态差异。
第二条水流:语言成为开放语义接口
图像描述曾经主要是“视觉 encoder + 文本 decoder”的单向翻译任务。Show and Tell 是这一范式的代表:图像被压成一个条件向量,语言模型据此生成 caption。它能够描述,却难以把任意语言概念反向变成视觉检索与分类接口。
CLIP 改变了接口:不再为每个封闭标签集训练分类头,而是把图像和文本映射到同一个对比空间。自然语言由输出形式变成了开放词表查询。随后几条路线解决“如何让语言模型持续读取视觉证据”:
- Flamingo 用 resampler 与 gated cross-attention,把视觉条件反复注入冻结语言模型;
- BLIP-2 用 Q-Former 在冻结视觉 encoder 与语言模型之间学习信息瓶颈;
- LLaVA 说明简单 projector 配合视觉指令数据也能形成有效基线。
这一步的实质不是“图片变成文字”,而是建立三层契约:
\(E_m\) 决定保留什么感知信息,\(P_m\) 决定以多少 token、什么位置和尺度接入,\(G\) 决定语言推理怎样访问证据。模型可能拥有很强的语言先验,却因低分辨率、过强压缩或错误坐标变换而看不清输入;因此 caption、OCR、grounding 与跨帧推理必须分开验证。
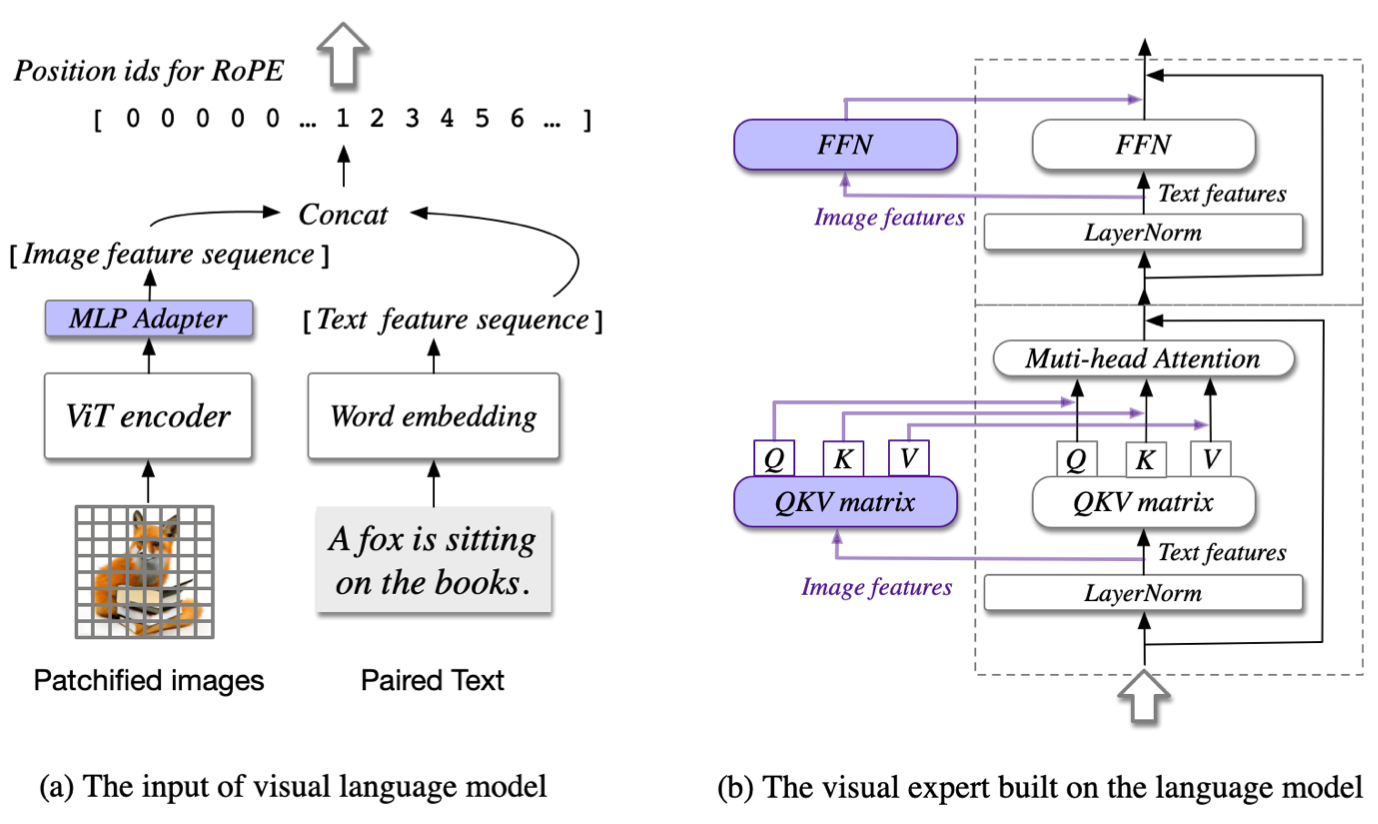
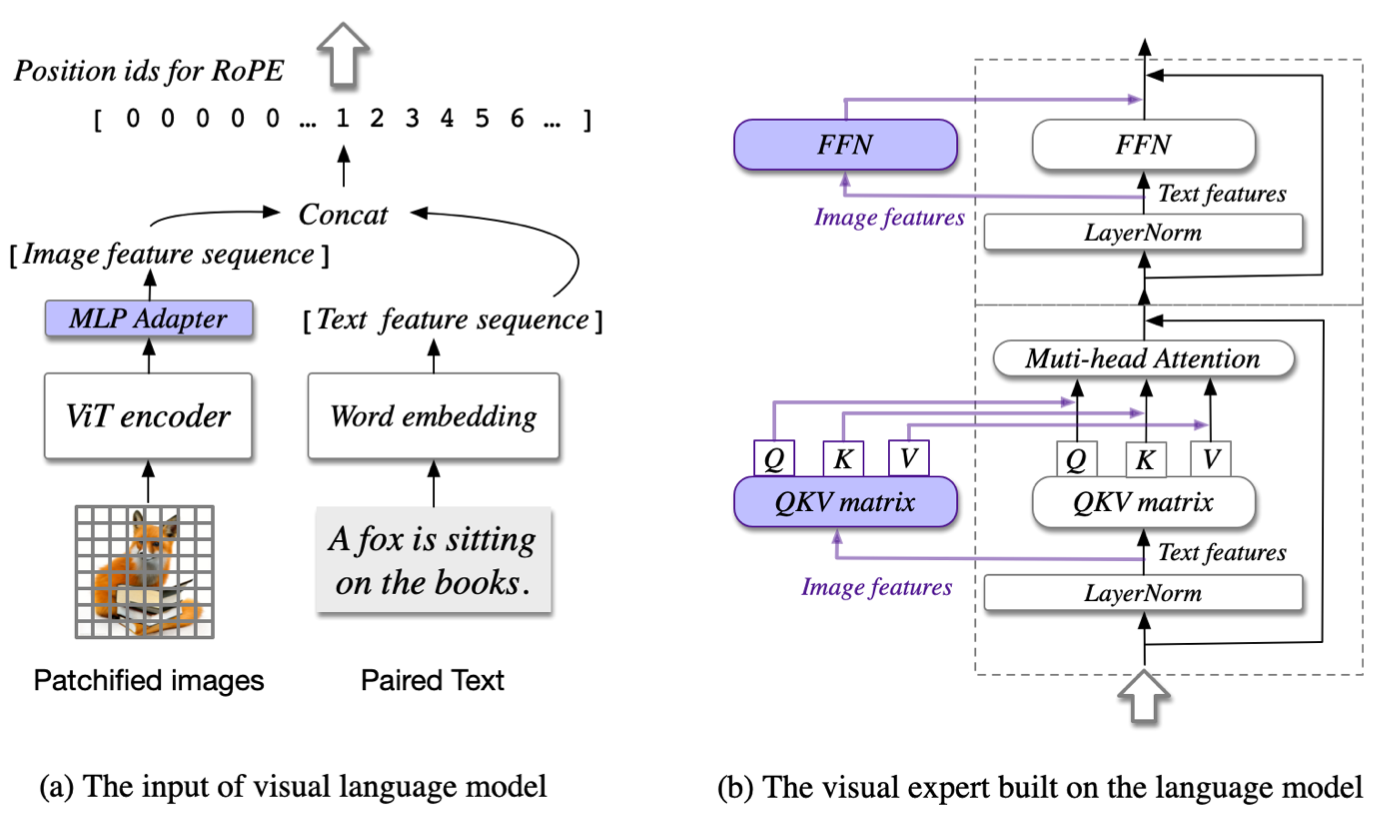
音频和视频也逐渐进入语言接口。Whisper 把多任务语音识别、翻译与时间戳统一为序列预测;CLAP 把声音与语言映射到共享空间;视频—语言模型则需要额外处理采样、镜头边界和事件顺序。语言提供了统一的任务描述,却不能代替模态内部的时空结构。
第三条水流:表示开始可逆
理解模型追求任务充分的表示;生成模型还要求表示能够恢复信号。两者的分叉可以用一个问题区分:
从表示中能否重建那些对当前语义任务不重要、但对感知质量重要的细节?
VAE 把数据映射到连续概率 latent,GAN 通过生成器与判别器博弈学习样本分布,PixelRNN/PixelCNN 则直接分解像素条件概率。三者分别强调可推断 latent、对抗式感知质量与精确似然分解,也暴露出模糊、训练不稳定和长序列采样等不同代价。
VQ-VAE 把图像压成离散码,VQGAN 进一步用感知和对抗目标改善重建。于是图像可以像文本一样交给自回归或 masked-token 模型处理。音频侧的 SoundStream 与 EnCodec 用多级量化码本在码率、语义和音质之间取舍;视频 tokenizer 还要同时压缩空间与时间。
另一条生成路线从连续扰动出发。DDPM 学习逆转加噪过程,Latent Diffusion 把计算移入压缩 latent,DiT 让 Transformer 成为可扩展去噪 backbone。Flow Matching 则把问题写成沿概率路径学习速度场。它们共享“从简单分布运输到数据分布”的几何,但训练参数化、时间方向、采样器和少步误差并不相同。
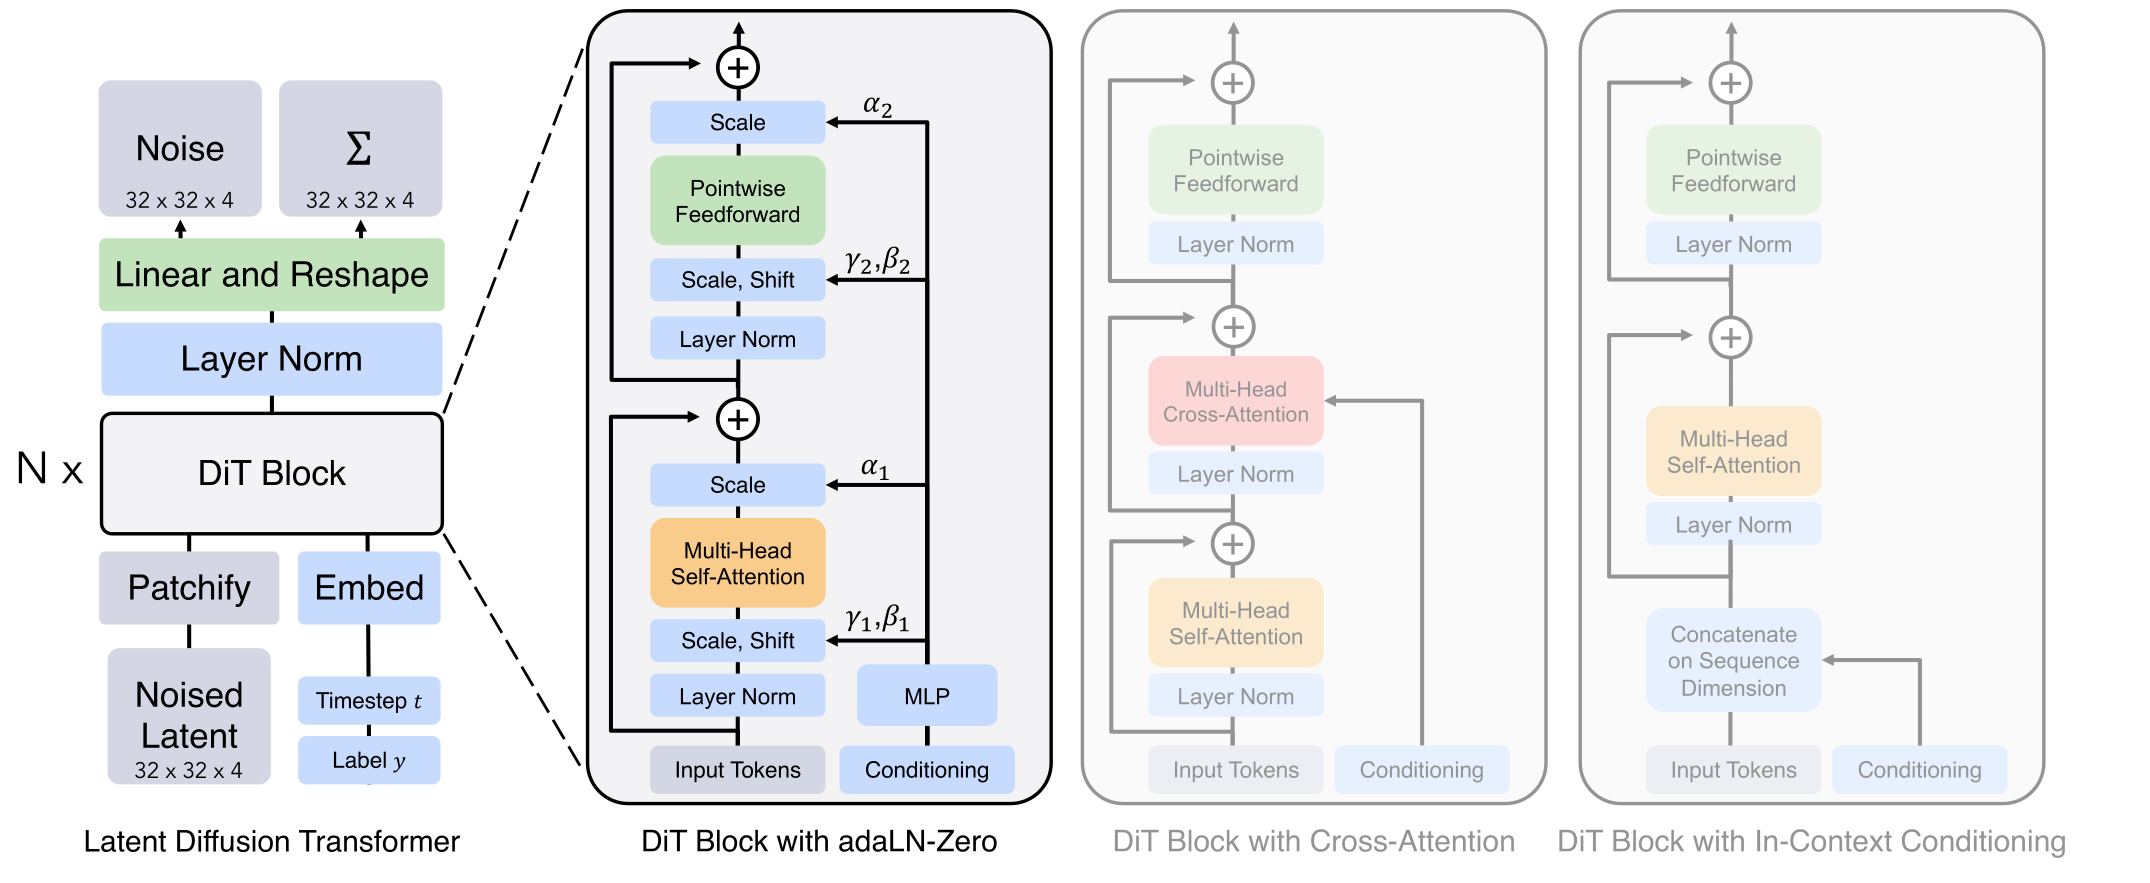
这条水流后来扩展到声音和视频:
- 波形生成从逐样本自回归走向 codec token、并行声码器与连续生成;
- 图像生成从单次文生图走向编辑、布局控制、身份保持与多轮交互;
- 视频生成从短片段外观逼真走向运动、镜头、音画同步和较长时间一致性。
媒体质量提高后,评测反而更难:像素距离不能代替语义忠实,人类偏好不能定位时间错误,单个展示样例也不能证明分布覆盖。
第四条水流:从生成下一帧到选择下一步
“生成未来”不自动等于“理解环境”。世界模型至少要说明:
- 状态包含哪些与行动有关的信息;
- 动作如何改变状态;
- 预测能否在闭环中支持规划;
- 误差在长时 rollout 中怎样累积。
World Models 把视觉压缩、潜在动力学和控制器拆开;PlaNet 与 Dreamer 在 latent imagination 中学习策略;MuZero 表明模型不必重建全部观察,也可以学习支持价值与策略预测的动力学。
另一支路线减少对像素重建的依赖。I-JEPA 与 V-JEPA 在表示空间预测被遮蔽的图像或视频区域;V-JEPA 2 进一步把视频预训练与机器人动作条件模型连接起来。这里的关键不是生成一张漂亮未来帧,而是预测对下游决策足够稳定的状态。
大规模交互式视频模型又把视觉生成与环境响应拉到一起。Genie 从无标注视频学习可控环境,Genie 2 和 Genie 3 继续强调交互、场景一致性和在线动作响应。它们提供了新的训练环境与模拟接口,但不能仅凭画面连贯就推断出精确物理、可靠因果或可迁移控制。
具身模型把接口推到最后一步。RT-1、RT-2、OpenVLA、\(\pi_0\)、Gemini Robotics 与 GR00T 等路线共同探索视觉、语言、状态与动作怎样共享主干。真正的困难落在闭环而不是单步输出:
动作 chunk 能降低推理频率,却会减弱突发事件下的响应;互联网视觉语言知识能改善语义泛化,却不能直接补足接触动力学;离线成功率也不能代替真实部署中的恢复、安全和延迟。
两次真正的汇流
第一次汇流发生在共享语义空间:视觉、声音与视频可以被语言查询,语言模型也能基于外部证据推理。
第二次汇流发生在共享生成与行动主干:同一系统既读取媒体,也输出媒体 token、连续 latent 或动作。此时“统一”不再只是输入格式,而涉及:
- 理解表示与重建表示是否共享;
- 自回归、diffusion 与 flow 目标怎样组合;
- 不同模态的 token 数和 loss 怎样平衡;
- 位置、时间、相机与机器人坐标系怎样贯通;
- 训练时的 teacher forcing 怎样过渡到真实闭环。
这也是现代多模态系统最容易混淆的地方:能力表面趋同,内部契约却可能完全不同。
怎样阅读接下来的章节
先读信号、表示与 Token 化,理解连续世界如何进入有限上下文;再按任务进入视觉表示与 Grounding、音频表示与理解和视频理解与长程记忆。生成路线从生成建模总览分流到离散生成、diffusion、flow、声音和视频专题;环境交互则沿世界模型与具身智能继续。
若要判断一项新工作真正改变了什么,可以依次问:
- 它改变的是表示、目标、数据、采样器,还是系统接口?
- 改进发生在单模态感知、跨模态对齐、生成还是闭环行动?
- 报告的指标能否定位改进来自哪里?
- 公开证据支持的是机制结论、实验结论,还是产品演示?
这样,新模型会落入一条可解释的历史河道,而不是变成另一串孤立名字。
Reference
- LeCun et al., Gradient-Based Learning Applied to Document Recognition
- Krizhevsky et al., ImageNet Classification with Deep Convolutional Neural Networks
- Radford et al., Learning Transferable Visual Models From Natural Language Supervision
- Alayrac et al., Flamingo: a Visual Language Model for Few-Shot Learning
- van den Oord et al., Neural Discrete Representation Learning
- Ho et al., Denoising Diffusion Probabilistic Models
- Lipman et al., Flow Matching for Generative Modeling
- Ha and Schmidhuber, World Models
- Assran et al., Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture
- Bruce et al., Genie: Generative Interactive Environments