音频生成:把声音写成可连续播放的序列
音频生成的难点并不只是“序列很长”。声音有一条不可回避的物理时间轴:相位错误会变成噪声,几十毫秒的停顿会改变语义,声码器晚到一帧就可能打断对话。音乐还同时要求毫秒级波形连续、秒级节奏与分钟级结构。于是,音频生成的发展始终围绕三个问题展开:
- 用什么表示承载波形细节,又不让序列长到无法建模;
- 用什么生成过程协调内容、音色、韵律、环境与长程结构;
- 怎样让模型在声音尚未结束时就开始生成,并稳定地接续下去。
这三问也解释了为什么语音、音乐和通用声音虽然共享 codec、Transformer 与扩散模型,却不能只用一个离线音质分数来比较。
若需要先建立采样率、STFT、Mel 和量化的共同语言,可从多模态信号与 token 化读起;识别、事件定位与音画理解则见音频理解。本页只沿生成链路推进,但沿用相同的物理时间契约。

从逐样本预测到神经声码器
在采样率 \(f_s=24\,\mathrm{kHz}\) 时,一秒单声道音频已经包含 \(24\,000\) 个样本。最直接的分解是
其中 \(c\) 可以是文本、音符、参考音色或视频。WaveNet 用扩张因果卷积证明了逐样本神经生成可以获得高保真波形,但这一分解把所有时间尺度都压在同一个循环里:推理步数与样本数同阶,音乐结构也很难跨越数百万步维持。
随后出现的关键转折不是简单地换一个网络,而是把“内容生成”与“波形实现”拆开。文本到语音系统先预测 Mel 频谱或其他声学特征,再由声码器还原波形;Tacotron 展示了 attention-based 文本到频谱,WaveGlow 用可逆流并行合成波形,HiFi-GAN 则用多尺度、周期判别器直接约束听感相关结构。扩散声码器如 DiffWave 把生成改写为逐步去噪,质量稳定但采样步数带来新的实时性压力。
这条历史线留下一个至今有效的分层:
端到端模型可以联合训练这几层,但只要最终需要扬声器播放,就仍要回答每层的带宽、时钟和延迟。
Codec token:把波形变成多码本序列
神经音频 codec 让生成模型不必直接面对每个采样点。SoundStream 和 EnCodec 以 encoder、残差向量量化(RVQ)和 decoder 构成压缩通道。设 encoder 每隔 \(h\) 个波形样本产生一个向量,frame rate 为
第 \(q\) 个码本依次量化上一层残差:
若有 \(Q\) 个码本、每个码本 \(K\) 个条目,忽略容器开销时码率约为
因此“每秒多少 token”不能只报 \(f_c\):一个时间帧可能同时含 \(Q\) 个离散 token。前几层码本通常承担粗结构,后几层补细节;这不是可任意交换的 \(Q\) 条独立文本序列。
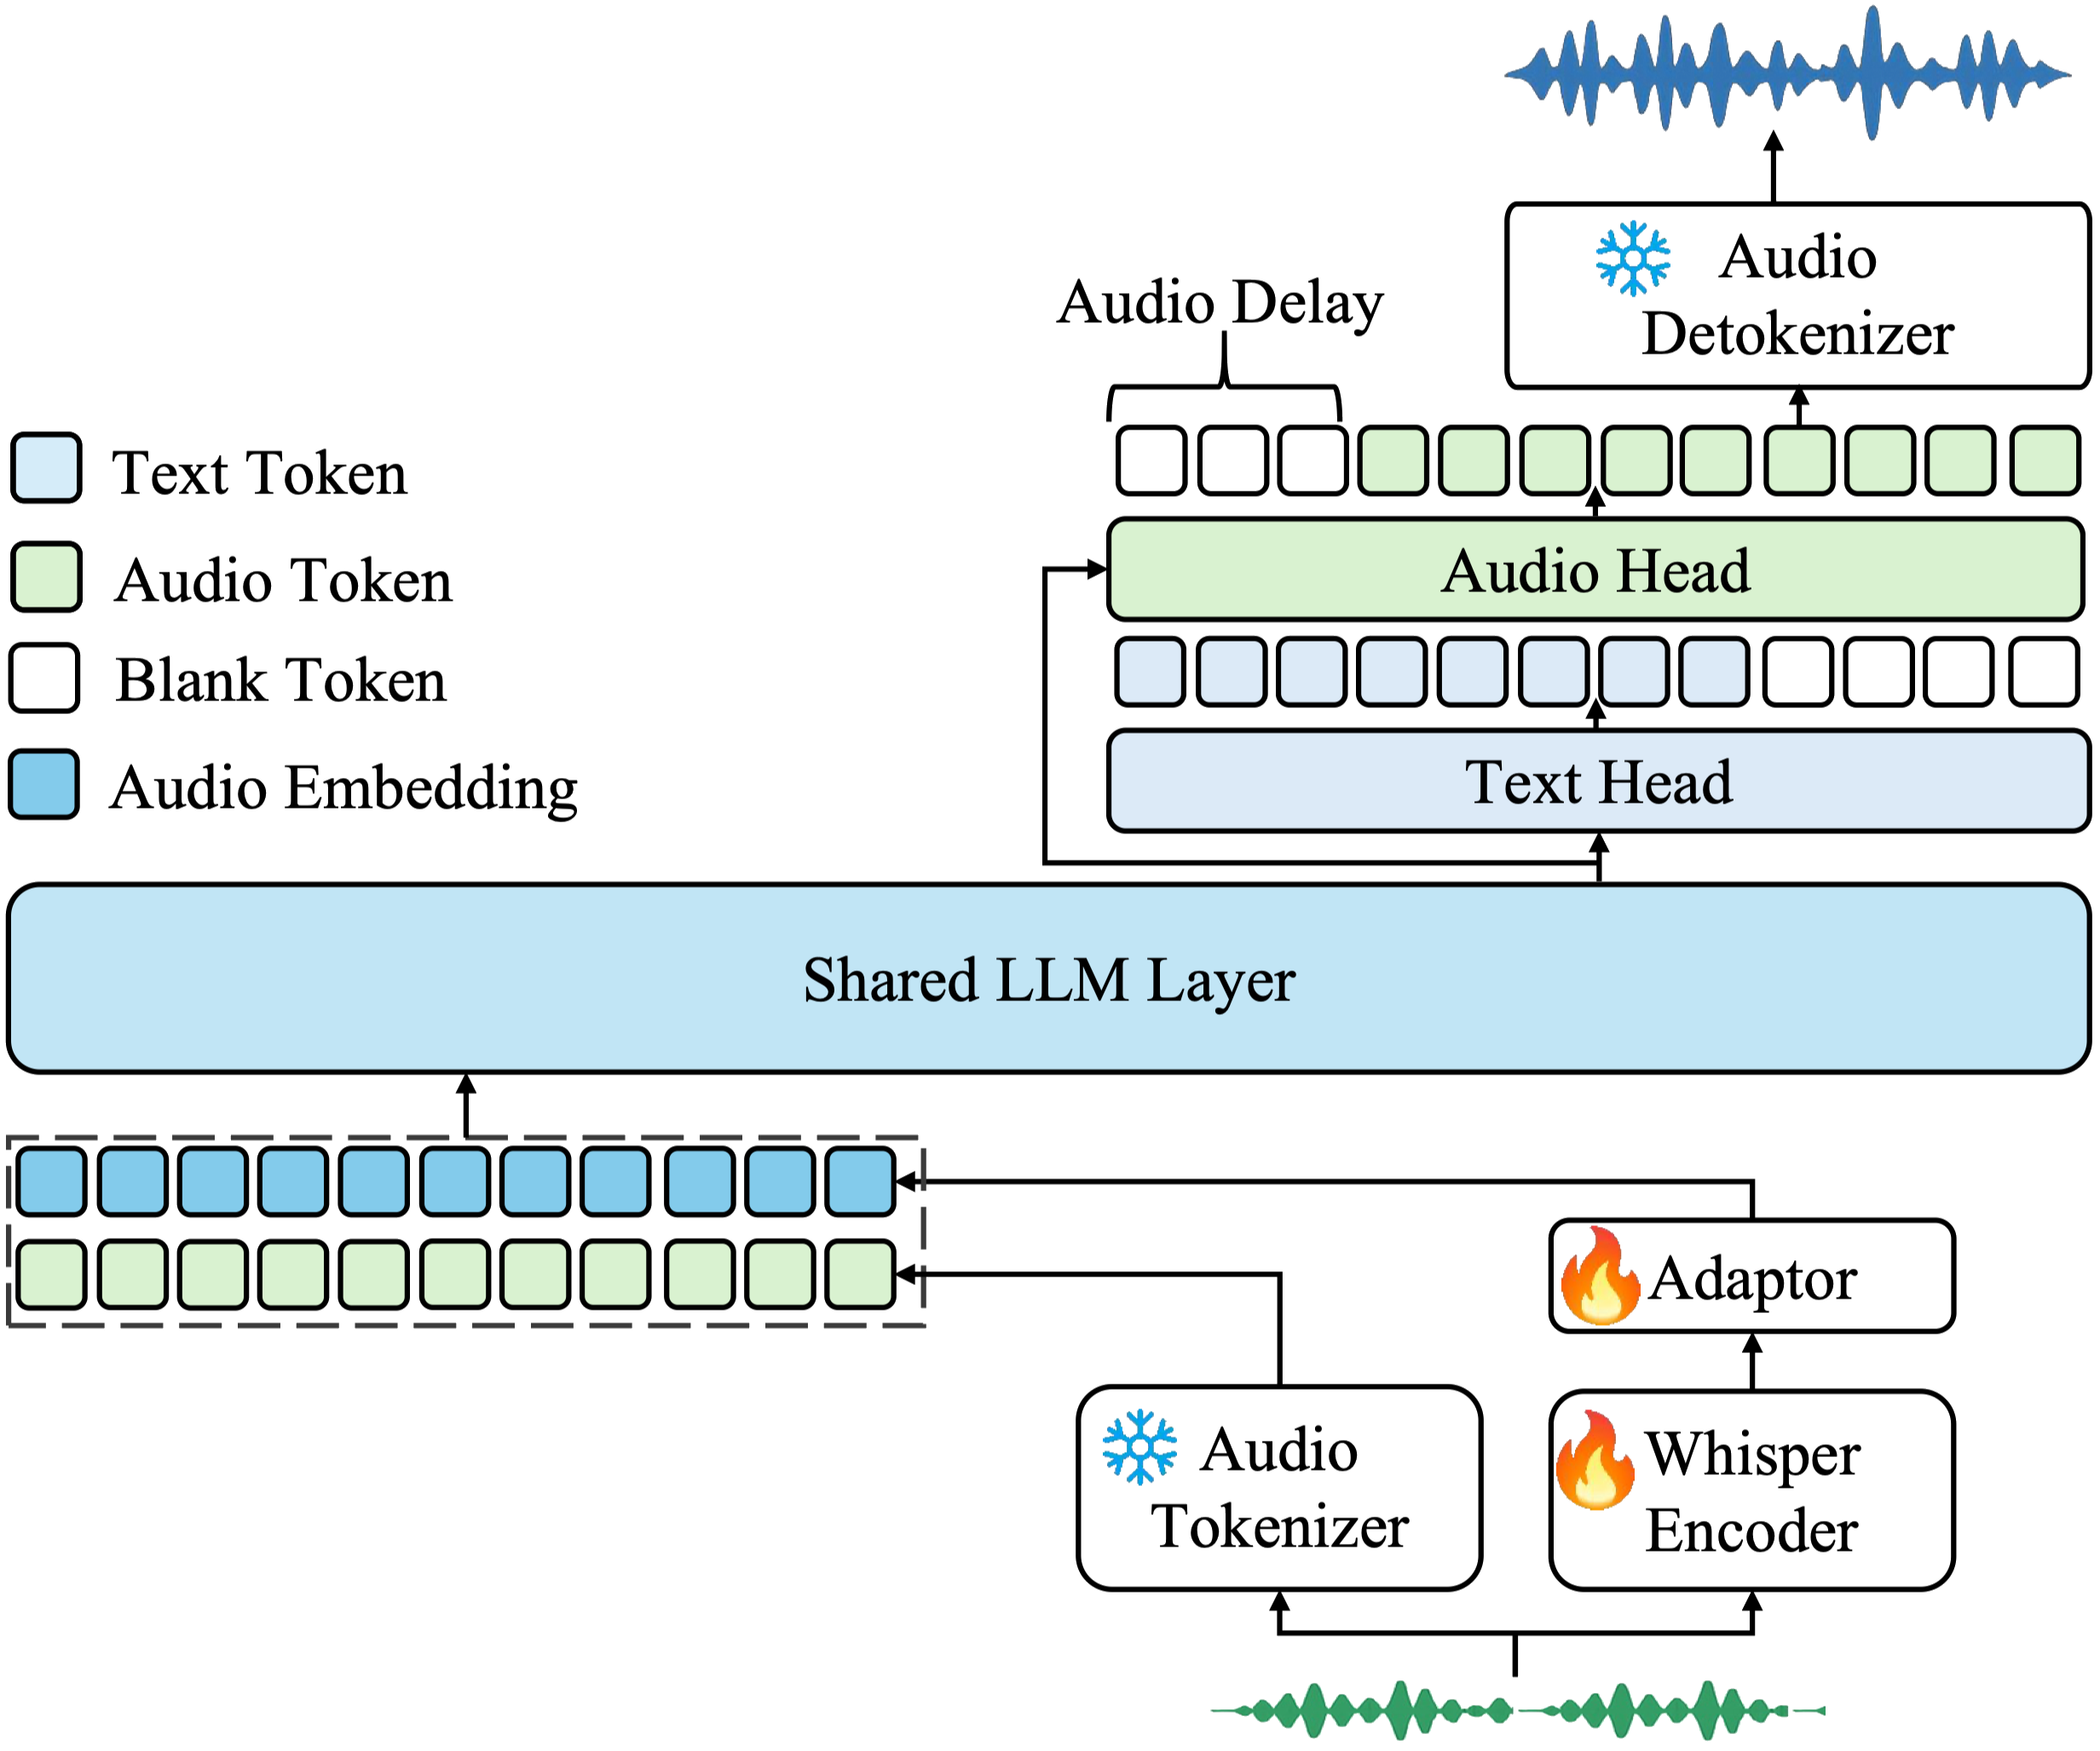
AudioLM 进一步把语义 token 与声学 token 分层建模;MusicGen 说明多码本可以用精心设计的 delay pattern 在单个自回归序列中生成。这样做的真正收益是对齐同一物理时刻的多个码本,同时避免每步串行生成 \(Q\) 次。
下面实现最小的 delay pattern。输入 code[b, q, t] 是 batch、码本、codec frame;输出 stream[b, s, q] 把第 \(q\) 个码本右移 \(q\) 步。-1 是尚未出现或已经结束的 padding,不是合法 token。
import torch
def delay_interleave(code, pad=-1):
    if code.ndim != 3:
        raise ValueError("code must be [batch, codebook, frame]")
    b, q, t = code.shape
    stream = code.new_full((b, t + q - 1, q), pad)
    for i in range(q):
        stream[:, i:i + t, i] = code[:, i]
    return stream
def delay_restore(stream, frames):
    if stream.ndim != 3 or frames <= 0:
        raise ValueError("stream must be [batch, step, codebook]")
    return torch.stack(
        [stream[:, i:i + frames, i] for i in range(stream.shape[2])],
        dim=1,
    )
code = torch.arange(2 * 4 * 6).reshape(2, 4, 6)
stream = delay_interleave(code)
restored = delay_restore(stream, code.shape[-1])
assert stream.shape == (2, 9, 4)
assert torch.equal(restored, code)
这段代码只定义了布局;训练时还必须让 loss 忽略 pad,推理时则要在对应码本真正开始后才采样。若把 padding 当成普通类别,模型会把序列边界学成可听伪影。
三条生成路线,以及它们为何共存
离散自回归
对 codec token 建模时,可以写成
其中 \(\mathcal A_s\) 是 delay 后第 \(s\) 步实际有效的码本。自回归模型天然适合逐步输出、续写和复杂条件,但误差会沿时间累积;音乐中一次节拍漂移,可能在后续变成结构性错位。Jukebox 以多层 VQ 表示和自回归 prior 生成长音乐,展示了层级离散建模的潜力,也暴露了采样成本与长程结构控制的困难。
连续扩散与 flow
另一条路线在波形、频谱或连续 latent 上定义噪声路径。以最常见的噪声预测为例:
AudioLDM 把文本条件扩散移入音频 latent;Voicebox 用非自回归 flow matching 处理语音补全与编辑;F5-TTS 进一步以 flow matching 简化文本到语音的对齐假设。连续生成擅长全局修正与编辑,但传统全序列去噪要等最后一步才得到成品,无法天然满足低延迟播放。
语义计划与声学渲染
长音频往往需要先决定“说什么/演奏什么”,再决定“如何发声”。VALL-E 把 TTS 表述为 codec language modeling;MusicLM 用层级序列协调文本语义与声学细节。分层能拉长规划跨度,却会产生接口失配:上层计划若丢掉时值、重音或和声信息,下层再逼真也只能忠实地渲染错误计划。
因此三条路线并非按年份互相淘汰。实际系统常把离散模型用于语义或粗声学计划,把扩散/flow 或神经声码器用于高保真渲染;应该按接口逐层检查,而不是给整套系统贴一个“AR”或“diffusion”标签。
条件控制:内容、身份与表现必须解耦
语音条件至少有四个轴:
- 文本或音素决定可读内容;
- 参考音频提供说话人和录音条件;
- prosody 控制时长、停顿、音高与能量;
- 语言、风格、情感或环境描述提供高层约束。
理想目标可写成
其中 \(y\) 是内容,\(s\) 是身份,\(r\) 是韵律,\(e\) 是环境。但数据通常把这些变量纠缠在一起:一个说话人只讲一种语言,某种情绪只出现在特定录音棚。模型于是可能把参考音频中的原句、噪声甚至背景音乐一并复制。零样本音色相似度高,也不等于内容、语言和情感可以独立控制。
音乐的控制轴更多:乐器、和声、节拍、段落、旋律和歌词不处在同一时间粒度。短文本 caption 只能约束整体语义;若要求某个和弦在第 17 秒出现,就需要时间标注、音符/MIDI 或可对齐控制轨,而不是反复改 prompt。
从“能续写”到真正的流式生成
把离线模型按窗口反复调用,并不自动得到流式系统。对第 \(k\) 个输入 chunk,在线状态应满足
其中 \(L\) 是已到达历史,\(R\) 是未来 lookahead。严格因果系统取 \(R=0\);允许小量 lookahead 可以改善边界,但它必须进入延迟预算。
端到端首包延迟至少包括
平均 real-time factor 小于 1 仍不保证首包够快,也不保证最慢 chunk 不欠账。需要区分:
- 首音频延迟:用户结束或开始说话后,第一段可播放波形何时到达;
- 稳态吞吐:每生成一秒声音需要多少墙钟时间;
- 算法 lookahead:模型必须等待的未来声音;
- 播放缓冲:为抵抗抖动而主动增加的延迟;
- 中断延迟:用户 barge-in 后,旧声音何时真正停止。
Moshi 把多流 audio language modeling 用于全双工语音对话,说明“同时听和说”需要独立时钟、因果状态与重叠语音训练,而不是轮流调用 ASR、LLM 和 TTS。Spirit-LM 把文本与语音 token 交织,展示了内容与表达信息在统一序列中的互补;它们仍需分别检验语义一致、音色稳定和重叠条件下的响应。
连续扩散/flow 也在向在线化发展:可用固定前缀、局部窗口、块因果 attention 或蒸馏把多步生成压缩到少数步。这里最容易犯的错误是让训练窗口看到未来,而部署窗口看不到;离线样例无缝,流式边界却产生爆音或音色跳变。
当音频 token 进入统一多模态语言模型,听、想、说三条流还会共享上下文与调度预算;相关协议和级联系统边界见音频与语音模型。
实现契约:先把时钟说清楚
一个可复现的音频生成接口至少应固定:
| 项 | 契约 |
|---|---|
| 波形 | float32 [batch, channel, sample];幅度范围、采样率、声道布局明确 |
| STFT | n_fft、window、hop、center/padding 与复数/幅相约定一致 |
| codec | [batch, codebook, frame];frame rate、码本顺序、词表和特殊 token 固定 |
| 文本 | tokenizer 版本、语言正规化与字符到音素路径固定 |
| 时间 | 全部 span 以秒或 sample 表示,不把 token index 当物理时间 |
| mask | 区分 padding、未到达未来、可见前缀和已生成位置 |
| cache | 每层 KV/卷积 state 的有效长度与 reset 条件明确 |
| 流式 | chunk、hop、lookahead、cross-fade、首包和中断协议明确 |
codec 帧 \(i\) 对应的波形范围通常近似为 \([ih,(i+1)h)\),但有 padding、卷积感受野时,decoder 输出边界还受上下文影响。拼接 chunk 时应在波形域交叠淡化,或让 decoder 保留连续状态;仅在 token 边界直接拼波形往往会产生 click。
常见失效不是一个“音质差”
局部逼真、内容错误
声码器能产生自然音色,却可能漏词、重复字、唱错歌词。语音应把 intelligibility 与 naturalness 分开;音乐应把歌词/旋律遵循与听感分开。
长程漂移
说话人音色、响度、房间混响或节拍随时间缓慢变化。短 clip 评测几乎看不到这类问题,必须按时长分桶并测跨段一致性。
边界伪影
流式 chunk 处的 click、相位断裂、重复音素和停顿跳变通常来自 state、padding 或 overlap 契约,而不只是模型容量。
条件泄漏与身份风险
参考音频可能泄漏原内容,训练数据可能让模型记忆具体声音。声纹相似度不能代替同意、授权和可追溯性;发布系统还应具备水印、滥用检测与明确的合成标识。
“更像指标”而不是更像声音
用外部 ASR 计算 WER 会继承该 ASR 的语言与口音偏差;CLAP 相似度偏好可被文本可预测的声学捷径利用;FAD 依赖 embedding、采样率和参考分布。指标应作为诊断视角,而不是单一排序器。
评测:质量、条件与实时性三张表
| 维度 | 代表检查 | 必须报告的切片 |
|---|---|---|
| 波形与感知 | MOS/MUSHRA、FAD、频谱与响度 | 耳机/扬声器、噪声、码率、时长 |
| 内容 | ASR WER/CER、歌词/音符一致性 | 语言、数字、人名、快慢语速 |
| 身份与表现 | speaker similarity、F0、时长、情感 | 跨语言、参考长度、未见说话人 |
| 文本/音频对齐 | CLAP、人工相关性、时间控制误差 | 具体事件、否定、组合 prompt |
| 长程 | 段落、节拍、音色漂移、重复 | 10 秒、1 分钟及更长 |
| 流式 | 首包、P50/P95 chunk、RTF、中断 | 不同硬件、并发、网络抖动 |
| 安全 | 记忆复现、身份冒用、水印检测 | 近邻训练样本、攻击性参考 |
盲测时必须响度匹配、随机顺序,并公开输入文本与失败样例。语音质量、说话人相似和文本正确性应分别打分;让受试者用一个总分同时判断三件事,会掩盖系统真正的改进来源。
变化中的前沿边界
以下只记录截至 2026-07-28 可由论文或官方页面核验的公开信息。论文中的效果均视为作者报告,需要在相同数据、采样配置和硬件上复验;产品页面只视为产品披露,不据此推断未公开架构。
- Stable Audio Open 与后续 Stable Audio 3 延续可变长度文本到音频的连续 latent 路线;后者的效率与质量结论是作者报告。
- SAME 研究语义对齐、高时间压缩率的音乐 autoencoder;其压缩率、重建与下游生成效果是作者报告。它改善的是生成底座的表示效率,本身不等同于完整的流式播放协议。
- Qwen3-TTS 公开了多语言可控 TTS 的技术报告;能力边界以该版本报告为准,不外推到同名在线产品的后续更新。
- HeartMuLa 研究开放音乐基础模型;数据、权重许可和生成内容使用范围仍须分别核对,不能由论文开放访问自动推出。
- Qwen3-Omni 报告了统一多模态理解与流式语音生成;这里把它作为作者报告的系统设计,不把产品体验反推为某种未披露声码器或训练配方。
这些工作共同指向“生成过程、codec 与交互协议联合设计”,而不是某一个离线 benchmark 的终局。判断新系统时,优先问它是否公开时钟、码率、采样步骤、首包、硬件、数据与对照协议。
codec、delay pattern 与流式状态的组合测试见多模态手撕实现。
Reference
- van den Oord et al., WaveNet: A Generative Model for Raw Audio
- Wang et al., Tacotron: Towards End-to-End Speech Synthesis
- Prenger et al., WaveGlow: A Flow-based Generative Network for Speech Synthesis
- Dhariwal et al., Jukebox: A Generative Model for Music
- Kong et al., DiffWave: A Versatile Diffusion Model for Audio Synthesis
- Kong et al., HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis
- Zeghidour et al., SoundStream: An End-to-End Neural Audio Codec
- Borsos et al., AudioLM: A Language Modeling Approach to Audio Generation
- Défossez et al., High Fidelity Neural Audio Compression
- Wang et al., Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers
- Agostinelli et al., MusicLM: Generating Music From Text
- Liu et al., AudioLDM: Text-to-Audio Generation with Latent Diffusion Models
- Copet et al., Simple and Controllable Music Generation
- Le et al., Voicebox: Text-Guided Multilingual Universal Speech Generation at Scale
- Nguyen et al., Spirit-LM: Interleaved Spoken and Written Language Model
- Evans et al., Stable Audio Open
- Défossez et al., Moshi: A Speech-Text Foundation Model for Real-Time Dialogue
- Chen et al., F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching
- Qwen Team, Qwen3-Omni Technical Report
- Qwen Team, Qwen3-TTS Technical Report
- HeartMuLa Team, HeartMuLa: A Family of Open Sourced Music Foundation Models
- Stability AI, Stable Audio 3
- Parker et al., SAME: A Semantically-Aligned Music Autoencoder