从 DSA 到 CSA/HCA:先压缩时间轴,再决定怎样寻址
DeepSeek-V4 的长上下文注意力不是把一个普通 attention kernel 换成稀疏 kernel。它连续改变了三件事:历史以什么粒度进入缓存、query 先从哪些历史块中筛选候选、被选中的表示怎样同时充当 key 与 value。Compressed Sparse Attention(CSA)选择“中等压缩后再稀疏”,Heavily Compressed Attention(HCA)选择 “强压缩后做稠密 attention”;两者再与未压缩的短滑窗交错,组成一套异构状态系统。
这条路线承接了 Multi-Query Attention、 Multi-head Latent Attention 和 DeepSeek Sparse Attention,但解决的维度不同:
| 机制 | 压缩什么 | 仍随上下文增长的部分 |
|---|---|---|
| MQA / GQA | KV head 数 | 每个历史 token 仍有 KV entry |
| MLA | 每个 token 的 KV 特征维 | token 数与 attention score 数 |
| DSA | query 真正读取的 token 数 | token 级 indexer cache 与候选池 |
| CSA | 时间轴先按 \(m\) 压缩,再选 top-\(k\) | indexer 扫描、短滑窗与未完成块 |
| HCA | 时间轴按 \(m'\gg m\) 压缩 | 对压缩序列的稠密 attention |
因此 CSA/HCA 既不是 MLA 的改名,也不是把历史压进固定维 recurrent state。它保存一条仍会 增长、但增长更慢的压缩序列;被压缩掉的 token 级细节不能从单个 entry 中无损还原。通用注意力 坐标见注意力家族,训练窗口、有效利用长度和测量边界见 长上下文。
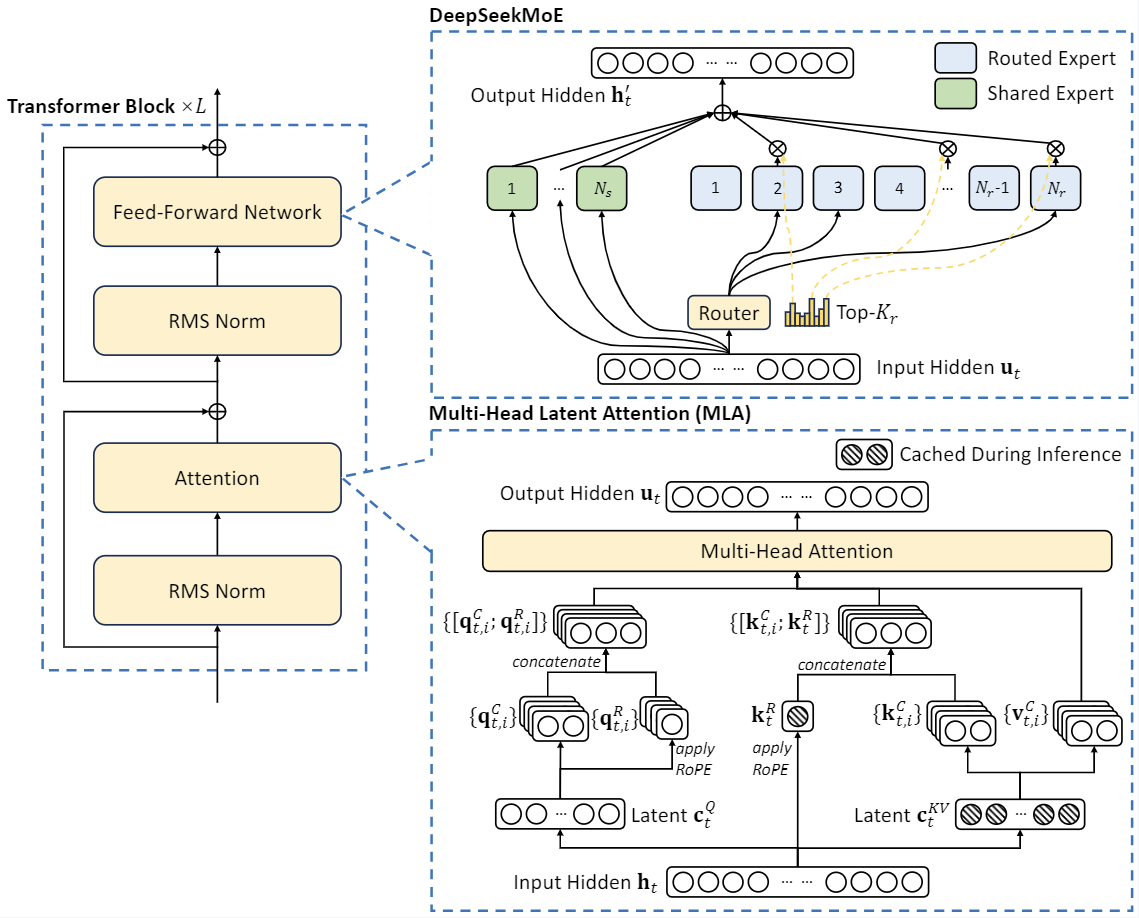
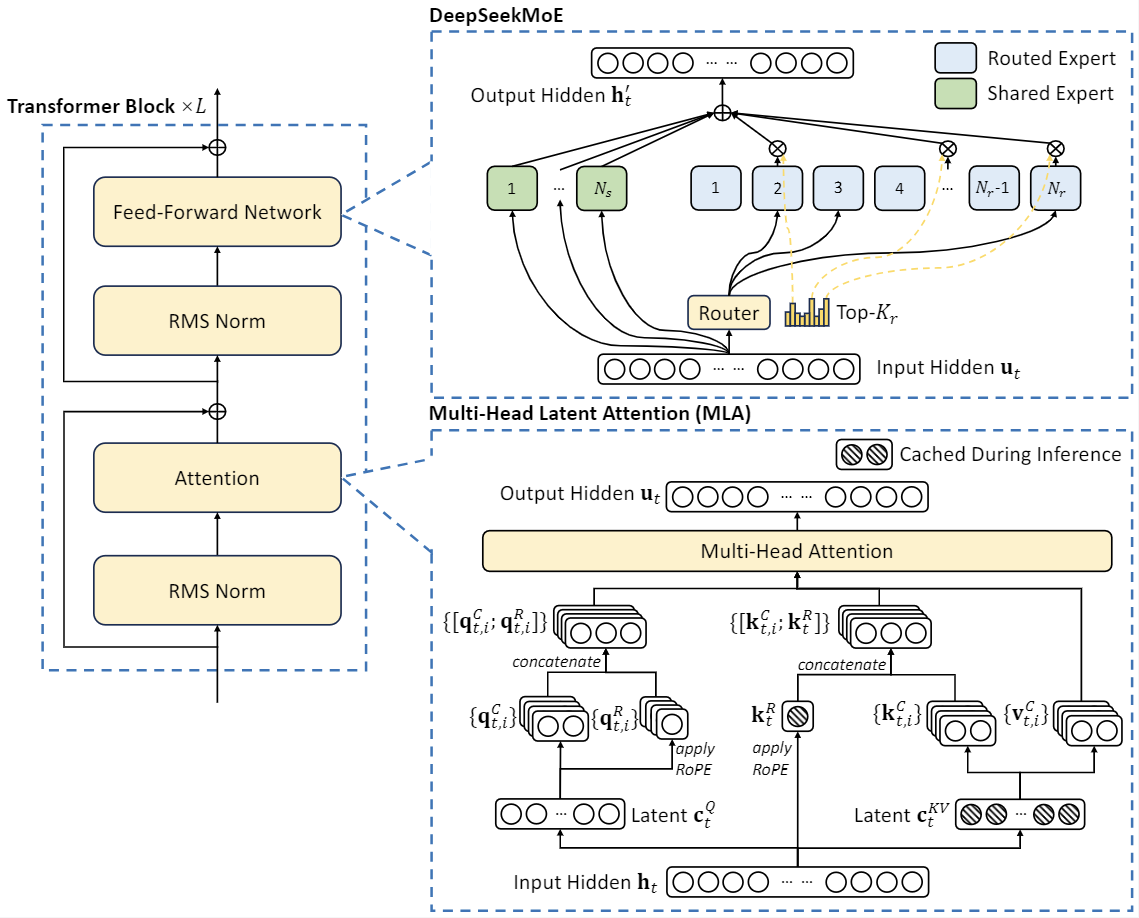
一张计算图
两条分支共享同一个外层结构:
hidden states
  ├─ recent uncompressed entries ───────────────┐
  └─ token compressor                           │
       ├─ CSA: compressed pool → indexer → top-k│
       └─ HCA: heavily compressed dense pool    │
                                                  ↓
                    shared-key-value MQA → grouped output projection
CSA 与 HCA 的关键差别不是“一个稀疏、一个稠密”这么简单:
| 维度 | CSA | HCA |
|---|---|---|
| 压缩窗口 | 两路、相邻窗口重叠 | 单路、不重叠 |
| 压缩率 | \(m=4\) | \(m'=128\) |
| 长程候选 | Lightning Indexer 选择 top-\(k\) | 全部压缩 entry |
| 额外状态 | compressed KV、compressed indexer key | compressed KV |
| 局部信息 | 共享一个 \(n_{\mathrm{win}}=128\) 的未压缩分支 | 同左 |
| 适合承担 | 较细粒度的内容寻址 | 极低成本的远程概览 |
V4-Flash 的前两层是纯滑窗,其余层交错 CSA/HCA;V4-Pro 的前两层是 HCA,其余层同样交错。 这种层间混合很重要:单独拿出 HCA 的 \(128\times\) 压缩率,不能推导完整模型仍能保存相同的 token 级证据;局部滑窗和 CSA 层也在共同补偿压缩损失。
CSA 的两路重叠压缩:公式 (9)–(12)
设输入为 \(H\in\mathbb R^{n\times d}\),head dimension 为 \(c\)。CSA 先产生两路候选 \(C^a,C^b\) 以及逐通道压缩 logits \(Z^a,Z^b\):
这里的压缩权重不是“一个 token 一个标量”。\(Z^a,Z^b\in\mathbb R^{n\times c}\),所以 每个输出通道都可以从窗口内不同 token 取信息。对第 \(i\) 个压缩 entry,第一路读取当前块 \([mi,m(i+1))\),第二路读取前一块 \([m(i-1),mi)\);\(B^a,B^b\in\mathbb R^{m\times c}\) 则提供块内相对位置偏置:
softmax 沿 \(2m\) 个候选位置进行、对每个通道分别归一化。压缩结果是
第一个块没有历史分支:其 \(Z^b\) 用 \(-\infty\) 填充、\(C^b\) 用零填充。每个 entry 虽读取 \(2m\) 个候选,但相邻 entry 复用窗口,输出步长仍是 \(m\),所以缓存长度约为原序列的 \(1/m\),不是 \(1/(2m)\)。
下面的最小实现固定了公式 (11)–(12) 最容易写错的三个语义:softmax 沿位置轴逐通道进行、 第一块屏蔽历史分支、后一输出读取前一块的 \(C^b\)。
import torch
def csa_compress(ca, cb, za, zb, ba, bb, m):
    assert ca.shape == cb.shape == za.shape == zb.shape
    n, c = ca.shape
    assert n % m == 0 and ba.shape == bb.shape == (m, c)
    out = []
    prev_c = torch.zeros_like(cb[:m])
    prev_z = torch.full_like(zb[:m], -torch.inf)
    for start in range(0, n, m):
        logits = torch.cat((za[start:start + m] + ba, prev_z + bb), 0)
        values = torch.cat((ca[start:start + m], prev_c), 0)
        out.append((logits.softmax(0) * values).sum(0))
        prev_c, prev_z = cb[start:start + m], zb[start:start + m]
    return torch.stack(out)
m, c = 2, 3
ca = torch.cat((torch.ones(m, c), torch.full((m, c), 3.)))
cb = torch.cat((torch.full((m, c), 2.), torch.full((m, c), 4.)))
z = torch.zeros(2 * m, c)
y = csa_compress(ca, cb, z, z, torch.zeros(m, c), torch.zeros(m, c), m)
torch.testing.assert_close(y[0], torch.ones(c))
torch.testing.assert_close(y[1], torch.full((c,), 2.5))
这段代码只实现压缩算子,不包含训练参数、padding 后的有效长度和分布式边界。生产实现还需处理 packed sequence:不同样本不能共享一个压缩窗口,尾部不足 \(m\) 的 token 也不能被下一条样本补齐。 这正是 sample-level mask 与 context parallel 必须理解“样本边界”而不能只看扁平 token offset 的原因。
Lightning Indexer:公式 (13)–(17)
压缩到 \(n/m\) 后,CSA 没有直接对全部 entry 做 core attention,而是沿用 DSA 的 query-dependent sparse selection。indexer key 使用相同的压缩结构:
query 则先经过低秩通道:
\(W^{DQ}\) 把 hidden state 压到 \(d_c\),再由 \(W^{IUQ}\) 生成 \(n_h^I\) 个 indexer query head。另一条投影生成 head 权重:
query \(t\) 与压缩块 \(s\) 的分数为
它不是普通多头 attention:各 head 的相似度先过 ReLU,再乘一个可为正负的动态 \(w^I_{t,h}\),最后才跨 head 求和。core attention 只读取分数最高的 \(k\) 个已完成块:
压缩降低的是候选池长度,top-\(k\) 降低的是昂贵 core attention 的读取量;indexer 自己仍需给候选 打分。因此“core attention 与上下文长度解耦”不等于整层计算完全成为 \(O(1)\):indexer scan、 候选 gather、cache 读取与 top-\(k\) 都仍有长度相关成本。V4 又把 indexer QK 路径纳入 FP4 量化感知训练,正是因为百万 token 下这条看似轻量的筛选路径会成为真实系统成本。
top-\(k\) 还引入一个算法边界:离散候选集合对微小 score 变化不连续。报告给出前向公式和公开 inference 实现,但不能由此补造未披露的 selector 训练梯度、辅助监督或边界 tie-breaking 细节;这些应以对应训练实现为准。
Shared-KV MQA:公式 (18)–(19)
core attention 的 query 与 indexer 共享 \(\mathbf c_t^Q\),但使用另一组上投影:
被选中的同一个 \(C_s^{\mathrm{Comp}}\) 同时作为 key 和 value:
这比 MQA 的“所有 query heads 共享一组 K/V”更进一步:K 与 V 本身也共享表示。收益是每个 compressed entry 只需保存一份 \(c\) 维向量;代价是用于匹配和用于读取的内容不能各自拥有独立 表示子空间。
V4 在 core attention 前对每个 query head 和唯一的 compressed-KV head 做 RMSNorm,避免 attention logit 随范数放大。随后只在向量最后 64 维施加 RoPE。因为 value 也带旋转后的绝对 位置,直接加权求和会把绝对旋转带进输出;模型因此对输出最后 64 维再施加 query 位置的逆旋转, 使每项贡献重新依赖 query–block 的相对位移。只对 query/key 加 RoPE、却忘记 shared value 上的逆变换,会实现出另一个模型。
下面把 indexer、top-\(k\)、shared KV 和 attention sink 缩成一个 query、一个 core head 的最小 实现。候选必须在调用前已按因果边界过滤。
import math
import torch
def sparse_shared_kv(q, iq, head_weight, ik, compressed, k, sink_logit):
    assert iq.ndim == 2 and ik.ndim == 2 and iq.shape[1] == ik.shape[1]
    assert compressed.shape[0] == ik.shape[0] and q.shape == compressed.shape[1:]
    similarity = torch.einsum("hc,sc->hs", iq, ik).relu()
    score = (head_weight[:, None] * similarity).sum(0)
    ids = score.topk(min(k, score.numel())).indices
    kv = compressed[ids]
    logits = q @ kv.T / math.sqrt(q.numel())
    normalizer = torch.logsumexp(torch.cat((logits, sink_logit[None])), 0)
    probability = (logits - normalizer).exp()
    return probability @ kv, ids, probability.sum()
iq = torch.tensor([[1., 0.], [0., 1.]])
ik = torch.tensor([[1., 0.], [0., 1.], [2., 2.]])
kv = torch.tensor([[1., 0.], [0., 1.], [1., 1.]])
out, ids, mass = sparse_shared_kv(
    torch.tensor([1., 1.]), iq, torch.tensor([.5, .5]), ik, kv, 2, torch.tensor(0.)
)
assert out.shape == (2,) and 2 in ids.tolist()
assert 0 < mass < 1
mass<1 不是数值误差:剩余概率质量流向了无 value 的 sink。它允许某个 head 对真实历史的总读取
接近零,而不必把概率强行分给一个无关 token。
HCA:公式 (20)–(26)
HCA 放弃 indexer,以更强的序列压缩换取对全部压缩 entry 的稠密寻址。它只生成一路 KV 与 压缩 logits:
对不重叠的 \(m'\) token 块,
这里仍是逐通道的 learned pooling,而不是简单平均。V4 使用 \(m'=128\),百万 token 最多形成 约八千个 HCA entries;作者据此选择省掉单独的 sparse indexer,让 query 稠密读取这条高度压缩 的历史。
HCA 的 query 同样先降维、再多头展开:
随后以全部可见 \(C^{\mathrm{Comp}}\) 同时充当 key 和 value:
HCA 的计算量仍随 \(n/m'\) 线性增长;“dense”描述的是压缩后的候选集合,不是原始百万 token。 相反,“heavily compressed”也不等价于语义无损:一个 128-token block 的所有细节都必须竞争 同一个逐通道 summary。它更像跨层提供远程轮廓,精细证据则依靠 CSA 和滑窗层补足。
因果边界与短滑窗
一个 compressed entry 只有在其来源块完整结束后才能被 query 看见。若 \(j\) 是从原始位置 \([mj,mj+m)\) 压出的 CSA entry,则 query 位置 \(t\) 至少满足
HCA 同理把 \(m\) 换成 \(m'\)。例如 \(m'=128\) 时,第一个 HCA entry 汇总位置 0–127;位置 100 不能读取它,因为其中含有未来信息,位置 127 也不能读取它,因为它仍属于当前块,直到位置 128 才能把它当作 preceding block 使用。只依赖 completed blocks 会让块内 token 彼此失联, 所以两种 attention 都拼接最近 \(n_{\mathrm{win}}=128\) 个未压缩 KV entries。
这形成三种不同生命周期:
- 已完成块进入 compressed cache;
- 尚未凑满 \(m\) 或 \(m'\) 的 tail 保持未压缩状态;
- 最近 token 同时进入固定长度 SWA state。
它们的更新率、block size、prefix 命中和逐出规则都不相同。因而 V4 的 cache 不能只用一个
[layers, blocks, heads, dim] 的 PagedAttention 布局描述;完整状态契约见
KV Cache 和缓存复用。
Attention sink:公式 (27)
CSA/HCA 都为每个 core head 增加一个不携带 value 的可学习 sink logit \(z'_h\):
普通 softmax 强迫真实 KV 的概率和为 1;加入 sink 后,其和可以落在 \((0,1)\),从而表达“当前 head 不需要从任何历史位置读取”。这与 StreamingLLM 中为了保持流式稳定而保留特定 sink token 有关联,但 V4 这里使用的是显式可学习 denominator term,不能把两者写成同一个实现。
Grouped output projection
core attention 产生 \(c n_h\) 维拼接输出,其中这里的 \(n_h\) 是 query head 数、\(c\) 是每 head 维度。V4 的 \(cn_h\) 很大,若直接投影回 hidden size \(d\),输出矩阵会成为显著计算成本。它先把 \(n_h\) 个 heads 分成 \(g\) 组,每组从 \(c(n_h/g)\) 投到 \(d_g\),拼接所有组后再从 \(gd_g\) 投到 \(d\)。
这不是标准 grouped-query attention:分组发生在输出 projection,而不是规定多少 query heads 共享一个 KV head。评估参数量或 FLOPs 时,必须把两级 projection 都计入,不能只计算 core-attention score。
两个已公开配置
| 配置 | V4-Flash | V4-Pro |
|---|---|---|
| Transformer layers | 43 | 61 |
| hidden size \(d\) | 4096 | 7168 |
| CSA compression \(m\) | 4 | 4 |
| HCA compression \(m'\) | 128 | 128 |
| indexer heads / dim | 64 / 128 | 64 / 128 |
| CSA top-\(k\) | 512 | 1024 |
| query heads \(n_h\) | 64 | 128 |
| core head dim \(c\) | 512 | 512 |
| query latent \(d_c\) | 1024 | 1536 |
| output groups \(g\) | 8 | 16 |
| per-group \(d_g\) | 1024 | 1024 |
| SWA window | 128 | 128 |
这些数字是 checkpoint 配置,不是 CSA/HCA 的定义常数。特别是 top-\(k\)、压缩率和层间比例会共同 决定质量、cache 与 kernel shape;只改变其中一个数字,不能假定沿用报告中的效率—质量结果。
系统收益从哪里来
设原始序列长 \(N\),忽略 tail 与滑窗:
- CSA main KV 约有 \(N/m\) 个 entries,core attention 每 query 读 \(k\) 个;
- CSA indexer 仍需维护并扫描约 \(N/m\) 个 index keys;
- HCA main KV 约有 \(N/m'\) 个 entries,core attention 读全部可见 entries;
- shared K/V 使每个 entry 只保存一份表示;
- 非 RoPE 部分使用 FP8 cache,indexer QK 路径进一步使用 FP4。
所以收益来自四个可相乘、也可能彼此掣肘的因素:序列压缩、候选稀疏、K/V 共享和低精度存储。 若 kernel 仍为每层建立不同 page 语义、频繁 materialize gather 结果,或压缩 tail 无法随 prefix cache 一起恢复,理论字节数不会自动变成服务吞吐。
报告给出的作者估算是:以 BF16 GQA8、head dim 128 为对照,V4 在 1M context 的 KV cache 约为其 2%;V4-Pro 相对 DeepSeek-V3.2 的单 token FLOPs 约为 27%,KV cache 约为 10%。 vLLM 的公开实现说明 进一步展示了统一 logical block、压缩器 tail state 和 hybrid cache manager 的落地方式。这些都是 特定层数、dtype、block layout 与硬件路径下的结果,不是任意 CSA/HCA 实现的固定倍率。
怎样验证,而不是只看平均分
算法语义
- 将 \(m=m'=1\),检查 compressor 是否退化为逐 token 表示。
- 第一块的历史分支必须严格为零,不能让 padding 获得概率质量。
- packed samples 的压缩窗口、SWA 与 indexer mask 都不得跨样本。
- query 处在未完成块内时,严格排除包含未来 token 的 compressed entry。
- shared KV 的 partial RoPE 与输出 inverse RoPE 应和逐项相对位置公式对齐。
- top-\(k\) tie、无有效候选和候选少于 \(k\) 时都要固定行为。
- sink probability 加入 denominator 后,真实 KV mass 应允许小于 1。
数值与 kernel
- BF16/FP8/FP4 路径分别对照 FP32 reference,并按序列长度报告误差。
- 对 compressor、indexer、gather、core attention 和 grouped projection 分项计时。
- 同时报告 HBM transaction、临时 gather bytes、cache page 浪费和 tail state。
- 检查不同 batch packing、prefix 命中与 P/D 分离后是否保持输出一致。
- 极端 logits、全相同 index score 与长序列累积误差需要独立压力测试。
能力
- needle retrieval 只能测显式定位,还要测跨块组合、顺序与否定关系。
- 将证据分别放在 CSA 边界、HCA 边界、滑窗外和多个远程块中。
- 同时报告 declared context、无失败运行长度、有效检索长度与长生成长度。
- 用 dense 或更低压缩 teacher 做局部对照,观察被压缩细节是否系统性丢失。
证据边界
- 报告完整定义了公式 (9)–(27)、两种模型配置和作者侧效率估算;公开 inference code 能进一步 约束 cache 与 mask 语义。
- 报告没有证明 learned compression 对所有任务无损,也没有证明百万 token 中任意位置都被均匀 利用。
- CSA 的 top-\(k\) 是内容相关稀疏,HCA 是压缩后稠密;把两者统称为 sparse attention 会丢掉 关键差别。
- V4 的收益来自整个 interleaved stack。不能把完整模型结果归因于 compressor、indexer、SWA、 shared KV 或量化中的单一组件。
- FP4/FP8、特定 top-\(k\) 和 cache layout 的速度结论依赖 kernel 与硬件;缺少端到端 profile 时, 理论 FLOPs 不能替代真实延迟。
模型结构、预训练和系统如何合成完整 checkpoint,见 DeepSeek-V4 深读;这条注意力路线在家族中的前后位置见 DeepSeek 演化案例。与有限状态路线的差别可继续对照 状态空间与线性注意力,高性能实现的共同 正确性约束见注意力 Kernel。
Reference
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DeepSeek-V4-Pro 官方 inference 实现
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- DeepSeek-V3.2-Exp 官方仓库
- Fast Transformer Decoding: One Write-Head is All You Need
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- Efficient Streaming Language Models with Attention Sinks
- vLLM 的 DeepSeek-V4 长上下文实现说明
- Transformers 的 DeepSeek-V4 模型文档