DeepSeek 家族:模型、方法与系统如何合流
DeepSeek 不是一条只按版本号递增的模型线。早期的语言、代码、数学和视觉分支先分别回答“数据与任务怎样专门化”;V2 / V3 把稀疏专家、潜变量注意力和低精度训练合成一套规模化主干;R1 把可验证奖励、长推理与蒸馏推到前台;V3.1—V4 又让统一思考模式、工具使用、稀疏长上下文和可恢复 Agent 系统彼此咬合。与此同时,DeepEP、FlashMLA、3FS 等公开物说明:模型结构是否成立,最终要由通信、kernel、存储和服务协议共同回答。
本页是家族入口,不重复每篇报告的逐节拆解。它固定区分 paper / report、checkpoint / weights / model card、code、dataset / evaluation harness、API / product 与 license 六类公开对象,并把发布日期作为每个对象各自的属性记录,再把技术线接回站内的机制页面。目录快照最后核验于 2026-07-28;模型库与 API 是持续变化的发布面,具体部署前仍应回到对应模型卡和服务文档。
家族地图
先把谱系画成四条相互交叉、却不能互相替代的线:
语言与稀疏主干
DeepSeek LLM ─→ DeepSeekMoE ─→ V2 / V2.5 ─→ V3 ─→ V3.1 / V3.2 ─→ V4
                         │          │          │                    │
                         │          │          └─ R1 ───────────────┤
                         │          └─ Coder-V2                     └─ Agent / 1M context
专门推理               Coder ─→ Math ─→ Prover V1 / V1.5 / V2 ─→ Math-V2
多模态                 VL ─→ VL2             Janus ─→ JanusFlow / Janus-Pro
文档压缩                                                     OCR ─→ OCR-2
系统公开物             3FS / DeepEP / DeepGEMM / FlashMLA / DualPipe / EPLB
                                         └─ TileKernels / DeepSpec / DualPath
箭头只表示有一手材料支持的初始化、继承或问题延续,不表示全部参数、数据与训练流程原样传递。尤其要避免三种常见的“看起来顺理成章”:
- Coder、Math 与 Prover 是专门化分支;它们影响后续通用模型的数据和后训练,却不等于每个通用 checkpoint 都完整继承其公开配方。
- R1-Zero、R1、R1-Distill 与后来的混合 thinking 模型处在不同训练阶段;“都会推理”不能消除 base、RL checkpoint、蒸馏 student 与服务端模型的边界。
- VL/VL2、Janus 与 OCR 分别处理视觉理解、理解—生成统一和文档压缩;“能看图”不足以把它们排成单线升级。
第一段历史:专门分支先于统一旗舰
DeepSeek-Coder 把仓库级代码、Fill-in-the-Middle 与长上下文纳入预训练,DeepSeekMath 从代码底座继续训练数学数据并提出 GRPO,DeepSeek-Prover 再把自然语言数学转进 Lean 证明。这里形成的不是三个孤立 benchmark 模型,而是一条逐步收紧反馈的链:
反馈越精确,训练信号越可靠;与此同时,任务分布也越窄,环境、编译器或证明器的版本依赖越强。后来 R1 把可验证奖励扩展到更大的通用推理模型,Prover-V2 则沿另一条路继续研究子目标分解与形式证明。
第二段历史:V2 同时改写容量和服务成本
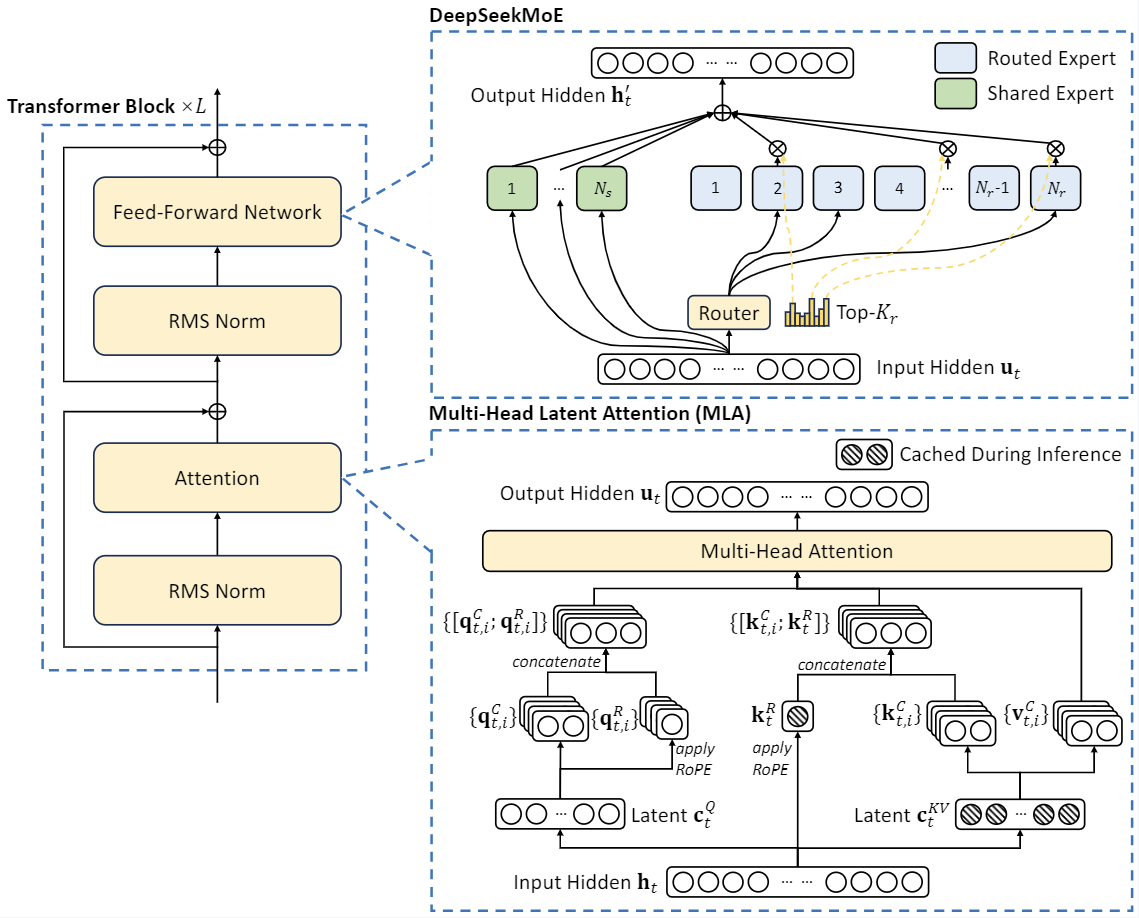
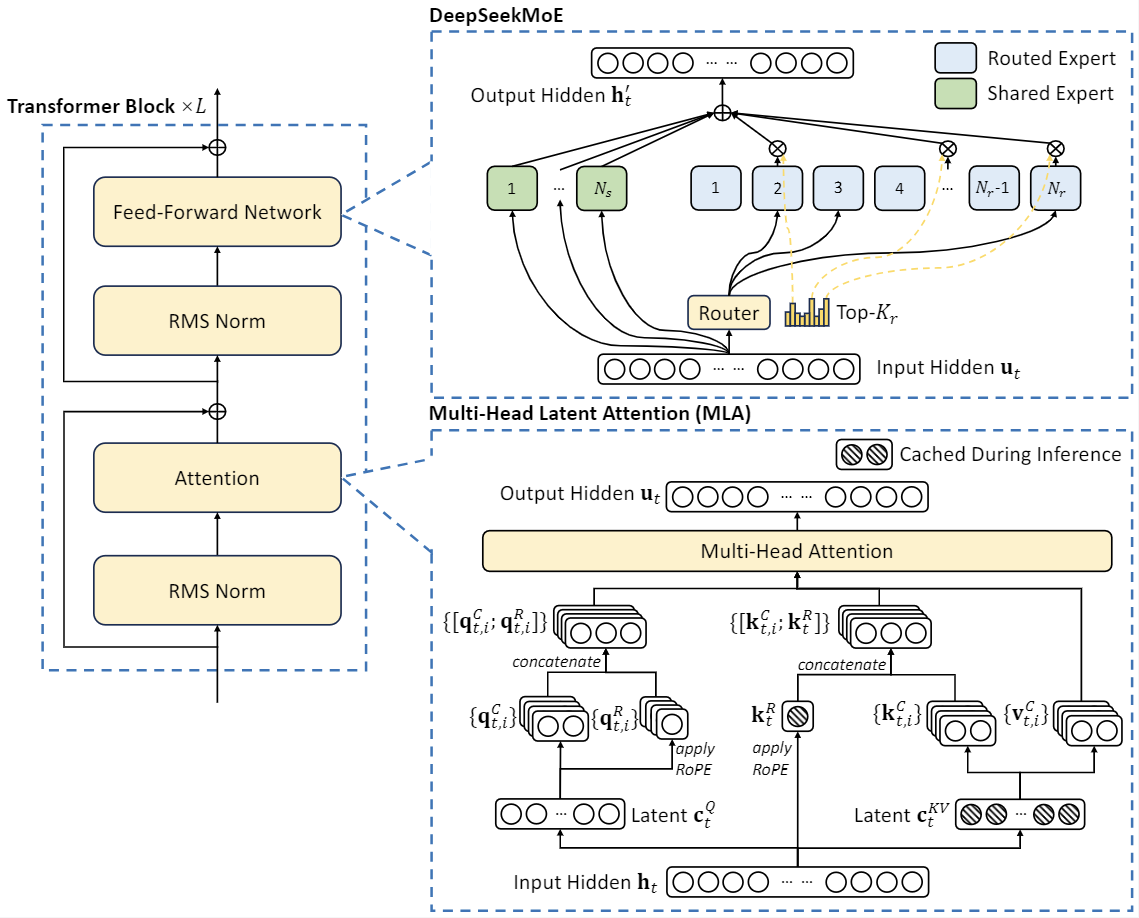
DeepSeekMoE 将专家细粒度拆分,并保留共享专家;DeepSeek-V2 把这条条件计算路线与 Multi-head Latent Attention(MLA)合并。对 token 表示 \(h\),MoE 层可抽象为
而 MLA 试图压缩每个 token 需要缓存的 K/V channel。前者减少每 token 激活的参数,后者减少 decode 时随序列累积的状态;两者分别把瓶颈推向 expert communication 与 attention kernel。因而 V2 的真正转折不是“参数更多”,而是模型容量、激活 FLOPs、KV cache 与跨设备通信必须联合预算。通用原理见 MoE、注意力家族和 MoE 系统。
第三段历史:V3 把训练系统写进模型配方
DeepSeek-V3 延续 MLA 与细粒度 MoE,又加入 auxiliary-loss-free balancing、Multi-Token Prediction、FP8 训练和 DualPipe。这里每项机制都要读两层:
| 模型层问题 | 系统层的必要条件 |
|---|---|
| routed experts 怎样保持专门化 | dispatch / combine、冗余专家和拓扑放置能否接住偏斜 |
| FP8 怎样降低训练成本 | scaling、累加精度、通信 dtype 与异常值怎样控制 |
| MTP 怎样增加未来 token 监督 | 额外训练头能否在推理时转成可靠 draft |
| pipeline 怎样隐藏通信 | stage 划分、micro-batch 与 activation memory 是否匹配 |
这也是 2025 年集中公开 DeepGEMM、DeepEP、FlashMLA、DualPipe、EPLB 与 3FS 后,报告中的效率主张才获得更细的可执行接口。公开 kernel 并不等于完整训练栈,但它能把 dtype、layout、shape 与硬件前提从口号变成可测试契约。
第四段历史:R1 把“产生推理”拆成多阶段闭环
DeepSeek-R1 最重要的辨析不是某个最终分数,而是四种作用不同的训练对象:
- R1-Zero 从 base model 直接用可验证 reward 做 RL,用于观察能力如何在缺少 reasoning SFT 时出现;
- cold-start 数据改善语言混杂、可读性与格式;
- rejection sampling、SFT 与第二阶段 RL 扩展任务覆盖;
- distillation 把大模型轨迹迁移到不同底座的小模型。
GRPO 常见的组内标准化只描述 advantage 的一部分:
它没有说明 reward 如何验证、无方差组怎样处理、长度归一化如何定义、rollout 是否来自当前 policy,也不能替代数据与系统设计。完整数学和工程边界分别见 GRPO、RLVR、推理后训练与知识蒸馏。
第五段历史:长上下文从结构问题变成状态问题
V3.1 将 thinking / non-thinking 合入同一 checkpoint,并把工具使用推入主要接口;V3.2-Exp 的 DeepSeek Sparse Attention(DSA)先用 Lightning Indexer 选择历史 token,再执行稀疏主注意力:
V4 进一步先压缩时间轴,再选择远程历史,并用 HCA 提供低成本全局概览、SWA 保留局部细节。百万 token 由此不再只是位置编码或 context length 配置,而是压缩误差、异构 cache、context parallel、持久前缀、抢占恢复、sandbox 状态与长程评测的共同问题。结构细节见 CSA / HCA,残差路径见 mHC,多专家能力合并见 On-Policy Distillation,端到端系统见 TileLang、MegaMoE 与 DSec。
公开产物账本
模型、论文与服务事件
下表记录家族主节点;日期是对应一手公开物的日期,不把论文、权重上传与 API 切换压成同一天。
| 时间 | 分支与公开对象 | 可以确认什么 | 不能顺手推出什么 |
|---|---|---|---|
| 2023-11 / 2024-01 | 仓库与 7B / 67B Base、Chat 权重先于 DeepSeek LLM 论文公开 | 语言主干、训练口径与早期开放 checkpoint;仓库/权重和论文是两个日期事件 | 当前 API 仍是该 Chat checkpoint |
| 2024-01 | DeepSeekMoE,16B Base / Chat | fine-grained experts 与 shared experts 的独立研究节点 | V2 之后的路由、系统和数据均已在此定型 |
| 2023-10—11 / 2024-01 | 1.3B—33B 仓库与权重先于 DeepSeek-Coder 论文公开 | 代码数据、FIM、仓库级依赖与专门评测;仓库/权重和论文是两个日期事件 | API 中曾经的 deepseek-coder 永久指向同一权重 |
| 2024-02 | DeepSeekMath,Base / Instruct / RL | 数学继续预训练、SFT、GRPO 与 reward model 实验 | 后来的 R1 只是 Math-7B 放大 |
| 2024-03 | DeepSeek-VL,1.3B / 7B | hybrid vision encoder、adapter 与视觉语言训练 | 与 Janus 共用同一生成路径 |
| 2024-05 | DeepSeek-V2,Lite 与主模型权重 | MLA、DeepSeekMoE 与 128K 语境下的结构—成本关系 | 后续 V2.5 的对齐数据和线上 checkpoint 可由 V2 报告补齐 |
| 2024-05—08 | Prover → Prover-V1.5 | synthetic formal data、proof-assistant feedback、RMaxTS;V1.5 公开 7B Base / SFT / RL | 搜索时 pass rate 等于单次模型能力 |
| 2024-06 | DeepSeek-Coder-V2,Lite / 236B Base 与 Instruct | 在 V2 架构上融合代码、数学与通用能力 | 线上 deepseek-coder 的每次更新都有独立技术报告 |
| 2024-09—12 | V2.5 及 V2.5-1210 | 通用与代码服务合并、产品 checkpoint 连续更新 | API alias 是稳定 checkpoint ID |
| 2024-10—2025-01 | Janus、JanusFlow、Janus-Pro | 理解/生成表示解耦、autoregression 与 rectified flow 的两种统一方式、数据与规模升级 | 三者的 encoder、生成目标与权重可以互换 |
| 2024-11 | R1-Lite-Preview | 在线预览公开了长 reasoning 与 inference scaling 现象 | 当时已经发布权重、训练代码或完整 R1 报告 |
| 2024-12 | DeepSeek-VL2,Tiny / Small / 主模型 | dynamic tiling 与 MoE 语言主干 | 视觉 token 更少必然带来更低端到端时延 |
| 2024-12 | DeepSeek-V3,Base / post-trained weights | 671B / 37B activated 主干、MTP、无辅助损失均衡、FP8 与 DualPipe | 公开的是完整生产训练器与数据集 |
| 2025-01—05 | R1 / R1-Zero / Distill → R1-0528 | 多阶段 reasoning post-training、六个 distill 模型及后续 checkpoint | Distill-Qwen / Distill-Llama 是 DeepSeek 原生架构,或与 R1 共享全部行为边界 |
| 2025-03 | V3-0324 | 新权重、服务升级及 MIT 许可切换记录 | 它是一份重写 V3 预训练过程的新报告 |
| 2025-04 | DeepSeek-Prover-V2,7B / 671B 与 ProverBench | 子目标分解、Lean 反馈与两种底座规模 | 自然语言 CoT 已经被形式证明器逐步验证 |
| 2025-08—09 | V3.1 → V3.1-Terminus | 单 checkpoint 双模式、128K、tool use 与连续服务修订 | 两个 API alias 是两套独立模型权重 |
| 2025-09—12 | V3.2-Exp → V3.2 / Speciale | DSA、thinking tool-use、agent data 与标准/强化 reasoning 变体 | 临时 Speciale endpoint 或旧 alias 仍长期可用 |
| 2025-10—2026-01 | OCR → OCR-2 | context optical compression 与 visual causal flow 两个文档模型节点 | OCR 压缩率等于字符、表格、公式和阅读顺序的无损恢复率 |
| 2025-11 | DeepSeekMath-V2 | 以生成、验证和 meta-verification 组织自验证数学推理 | verifier 自评分可以替代外部正确性检查 |
| 2026-01 | Engram,代码与 checkpoint | conditional memory / lookup 是独立于 MoE 的稀疏轴 | V4 已经采用 Engram;V4 报告只把它放在后续方向 |
| 2026-04-24 | V4 Preview 发布与 Flash / Pro、Base / post-trained 集合 | 284B / 13B 与 1.6T / 49B 两种规模、1M context、开放权重与两个新 API model ID | 发布说明等同于完整训练配方;模型集合的后续文件修订等同于新基础代际 |
| 2026-04-26 | DeepSeek-V4 技术报告 | CSA / HCA、mHC、Muon、OPD、FP4 / FP8 混合权重、训练与评测的报告口径 | 报告披露了训练数据配比、总 FLOPs、硬件规模和全部 RL 环境;报告日也不能覆盖权重与 API 的独立 revision |
| 2026-07 | DSpark 深读、论文、DeepSpec 与 V4 DSpark attachments | semi-autoregressive drafter、confidence-scheduled verification 及训练/评测框架 | DSpark 改变了 V4 base model,或论文速度可脱离并发与验证协议复用 |
API 名称尤其容易误导。官方变更记录显示,deepseek-chat 曾依次路由到 V2、V2.5、V3、V3.1、V3.2,deepseek-reasoner 也曾从 R1 更新到后续 hybrid model;V4 发布时又给出 deepseek-v4-pro 与 deepseek-v4-flash 新标识,并宣布旧 alias 的退役时间。历史实验若只写 alias、不记录请求日期、实际模型标识和模板,就无法复现。
| 服务日期 | alias / 系统事件 | 当时指向或新增的公开行为 |
|---|---|---|
| 2024-05-17 / 06-28 | deepseek-chat |
V2-0517 → V2-0628 |
| 2024-06-14 / 07-24 | deepseek-coder |
Coder-V2-0614 → Coder-V2-0724 |
| 2024-07-25 | API 协议 | JSON、function calling、chat prefix 与 FIM 等接口扩展 |
| 2024-08-02 | context caching | 服务端磁盘 prefix cache;不是模型架构中的 KV 压缩 |
| 2024-09-05 / 12-10 | deepseek-chat / deepseek-coder |
合并到 V2.5,随后 deepseek-chat 更新为 V2.5-1210 |
| 2024-12-26 / 2025-03-24 | deepseek-chat |
V3 → V3-0324 |
| 2025-01-20 / 05-28 | deepseek-reasoner |
R1 → R1-0528 |
| 2025-08-21 / 09-22 / 09-29 | deepseek-chat / deepseek-reasoner |
V3.1 → V3.1-Terminus → V3.2-Exp 的 non-thinking / thinking modes |
| 2025-12-01 | 两个旧 alias;临时 Speciale endpoint | V3.2 双模式;Speciale 是限时、无 tool call 的独立服务面 |
| 2026-04-24 | deepseek-v4-pro / deepseek-v4-flash |
V4 两种规模、双模式与 1M context;旧 alias 的退役计划另行记录 |
这张服务表来自同一份官方 Change Log。它是“当时服务如何路由”的历史,不是权重之间可逐位比较的 lineage。
代码、权重与许可证不是一回事
早期许多仓库同时放置 LICENSE-CODE 与 LICENSE-MODEL,代码可用 MIT 并不自动让权重变成 MIT。R1、V3-0324、V3.2 与 V4 等后续公开物又有各自许可记录;Math-V2、Engram、OCR-2 的仓库当前标注 Apache-2.0。最稳妥的做法始终是:
- 锁定准确的模型仓库和 revision;
- 分别读取模型卡、权重许可证、代码许可证和数据集许可证;
- 记录衍生底座,例如 R1-Distill-Qwen 与 R1-Distill-Llama 还受其底座关系影响;
- 不用 GitHub 页面自动识别出的仓库 license 覆盖模型卡中的单独条款。
可直接核验的代表性入口包括 R1 LICENSE、V3 的 code license 与 model license、V3.2-Exp LICENSE、V4 Flash 与 Pro 的模型文件,以及 Math-V2、Engram 和 OCR-2 的仓库许可。许可证可能随 revision 变化,实际使用仍须锁定所下载工件并自行完成合规判断;这里不是法律意见。
官方 GitHub 组织的公开仓库快照
截至 2026-07-28,官方组织可见 35 个 public repositories。为了让目录既可核验又不把不同对象混在一起,这里按角色完整列出:
| 角色 | 公开仓库 | 边界 |
|---|---|---|
| 模型、报告与一手方法 | DeepSeek-LLM、DeepSeek-Coder、DeepSeek-MoE、DeepSeek-Math、DeepSeek-VL、DeepSeek-V2、DeepSeek-Coder-V2、ESFT、DeepSeek-Prover-V1.5、Janus、DeepSeek-VL2、DeepSeek-V3、DeepSeek-R1、DeepSeek-Prover-V2、DeepSeek-V3.2-Exp、DeepSeek-OCR、DeepSeek-Math-V2、Engram、DeepSeek-OCR-2 | 有些只含报告、推理示例或局部训练代码;仓库存在不等于端到端训练可复现 |
| Kernel、通信、数据与训练/服务系统 | open-infra-index、DeepGEMM、DeepEP、FlashMLA、smallpond、profile-data、EPLB、DualPipe、3FS、LPLB、TileKernels、DeepSpec | 这些是模型谱系的系统证据或邻接工具,不应全部改写成某个 checkpoint 的组成部分 |
| 独立研究与聚合目录 | DreamCraft3D、awesome-deepseek-coder、awesome-deepseek-integration、awesome-deepseek-agent | DreamCraft3D 是独立 3D 生成研究;三个 awesome-* 是链接集合,不是官方兼容性认证或模型实现 |
这张表也解释了几个“没有单独仓库”的节点:DeepSeek-Prover V1 主要由论文与模型发布定义,V1.5 才有独立组织仓库;auxiliary-loss-free balancing、mHC、Muon scaling 与 DualPath 首先是论文或报告节点,相关实现可能散落在 V3/V4、TileKernels 或内部系统中,不能因为作者隶属相同就假设存在完整 reference implementation。
官方 Hugging Face 模型目录还包含 Base、Chat/Instruct、RL、Distill、精度变体、DSpark drafter 与附件 checkpoint。它是下载对象的动态事实源;本页按“模型族与训练阶段”归并,不把量化副本、draft attachment 或同一模型的上传修订误当成新的基础模型代际。
能力与机制怎样接回主干
按模型名阅读容易得到一串名词;按问题阅读,家族的贡献会落到更稳定的坐标:
| 问题 | DeepSeek 节点 | 应继续阅读 |
|---|---|---|
| 稀疏容量怎样扩展 | DeepSeekMoE、V2、V3、V4、Engram | MoE、稀疏与替代架构、条件计算谱系 |
| KV 与长历史怎样降本 | MLA、DSA、CSA/HCA、OCR context compression | 注意力家族、长上下文、KV Cache |
| 可验证推理怎样训练 | Math、R1、Prover、Math-V2 | 推理策略优化谱系、GRPO、RLVR |
| 专家能力怎样合并 | R1 distillation、V4 full-vocabulary OPD | 知识蒸馏、On-Policy Distillation 深读 |
| 低精度怎样贯穿训练与部署 | V3 FP8、V4 FP4/FP8、DeepGEMM | 精度与数值、量化、Kernel 与性能 |
| MoE 通信怎样不吞掉稀疏收益 | DeepEP、EPLB/LPLB、MegaMoE | MoE 系统、集合通信与状态分片 |
| 长程 Agent 状态怎样恢复 | V4 token WAL、3FS、DSec、DualPath | Cache 复用、Agentic RL 训练系统、工具使用 |
| 理解与生成怎样统一 | VL/VL2、Janus/JanusFlow/Pro、OCR | DeepSeek 多模态案例、统一理解与生成、文档与 GUI Grounding |
| 推测解码怎样服务真实并发 | V3 MTP、V4 MTP、DeepSpec / DSpark | 推测解码、调度与 Goodput |
| 结果怎样避免被 benchmark 名称误导 | R1、V3.2、V4、Prover/OCR | 语言模型评测协议、Agent 与工具评测、多模态评测 |
站内阅读路径
想先看清整条历史
从 DeepSeek 演化案例进入。它按时间解释 LLM、Coder、Math、MoE、R1、多模态和 V4 怎样相交;本页的账本用于核对公开对象,两页互补。
想理解 reasoning 不是怎样被一个公式“发明”的
依次阅读 DeepSeek-R1 深读 → GRPO → RLVR → 推理后训练。这条路径会把 reward、estimator、采样、冷启动、蒸馏与 evaluation protocol 分开。
想拆开 V4 的结构与系统
先读 DeepSeek-V4 总深读,再按问题进入:
- CSA / HCA:压缩器、因果边界、indexer 与最小实现;
- Manifold-Constrained Hyper-Connections:宽 residual stream、双随机约束与稳定性;
- On-Policy Distillation:student-prefix 上的全词表教师分布;
- TileLang、MegaMoE 与 DSec:kernel、混合 cache、WAL、sandbox 与容错;
- V4 引用图谱:报告 103 项实际引用的角色、归因与后续公开物边界。
想理解多模态分支
DeepSeek 多模态案例比较 VL、VL2、Janus 与 OCR;再进入视觉表示与 Grounding、统一理解与生成和多模态评测。这条路径不会把图像理解、图像生成和文档压缩合成一个模糊的“视觉能力”。
想从公开代码理解生产约束
按数据路径读比按仓库名读更顺:
data / checkpoint / prefix state
3FS + smallpond
        ↓
training parallelism
DualPipe + DeepEP + EPLB/LPLB
        ↓
model kernels
DeepGEMM + FlashMLA + TileKernels
        ↓
serving
KV cache + disaggregation + DeepSpec/DSpark
对应站内主干是分布式训练系统谱系、训练系统、推理运行时谱系与推理服务。
仍然未知
公开材料已经足以重建许多设计因果,却仍不足以把生产系统逐行复制。当前应明确保留的空白包括:
- 多数旗舰模型没有公开训练数据的完整组成、去重规则、污染审计样本和逐阶段 token 明细;
- V3/V4 的总训练 FLOPs、完整硬件拓扑、失败实验、所有超参数与端到端训练器没有整体开放;
- R1、V3.2、V4 的 RL 数据生成、reward routing、采样预算、过滤阈值和 policy-version 管理只披露到不同粒度;
- API / 产品 checkpoint 可能在不改变公开 model name 的情况下更新;服务端 system prompt、工具 runtime、缓存与安全策略也会改变行为;
- V4 仍标为 Preview;其报告明确保留架构简化、多模态与新稀疏方向,不能把路线图写成已经实现的能力;
- GitHub 公开代码多为关键模块或 reference path,不代表内部生产分支、编译参数和集群调度策略逐项相同;
- benchmark 表格只有在 prompt、sampling、token budget、tool harness、scoring 与统计区间一致时才可横向比较;
- 代码与模型许可会随具体 artifact 变化,本文不是法律结论,部署时必须核对目标 revision。
这些空白不是需要用传闻补齐的“缺资料”,而是阅读结论的一部分。下一次更新应新增独立事件和证据,不覆盖旧 checkpoint,也不把后续报告的机制倒写进早期模型。
Reference
- DeepSeek 官方 GitHub 组织与公开仓库
- DeepSeek 官方 Hugging Face 模型目录
- DeepSeek API Change Log
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- DeepSeek-Coder: When the Large Language Model Meets Programming
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- DeepSeek-VL: Towards Real-World Vision-Language Understanding
- DeepSeek-V2
- DeepSeek-Prover
- DeepSeek-Coder-V2
- Expert-Specialized Fine-Tuning
- DeepSeek-Prover-V1.5
- Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts
- Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning
- Janus
- JanusFlow
- DeepSeek-VL2
- DeepSeek-V3 Technical Report
- DeepSeek-R1
- Janus-Pro
- Muon is Scalable for LLM Training
- DeepSeek-Prover-V2
- Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures
- DeepSeek-OCR
- DeepSeekMath-V2
- DeepSeek-V3.2
- mHC: Manifold-Constrained Hyper-Connections
- Engram: Conditional Memory via Scalable Lookup
- DeepSeek-OCR 2: Visual Causal Flow
- DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation