推理后训练
推理后训练不是单一算法,而是一条把候选生成、搜索、验证与策略学习连接起来的闭环。任务可以在推理时花更多计算寻找答案,也可以把搜索到的轨迹转成 SFT、偏好、过程监督或 RL 数据;两者的成本和泛化边界不同。
问题分解
“推理能力”至少包含:
- 产生有希望的中间状态;
- 在多个候选间保持多样性;
- 判断局部步骤和最终答案;
- 分配有限搜索预算;
- 从失败中恢复或回溯;
- 将一次搜索收益迁移到不搜索或少搜索的模型。
只让模型输出更长文本,可能增加采样成本,却不保证这些能力中的任何一项改善。
推理时计算
Best-of-\(N\)
单次成功概率为 \(p\) 且样本独立时,至少一次成功概率为
真实候选通常相关,公式只给理想参考。还需要一个能从 \(N\) 个候选中选出正确答案的 verifier;若选择器不可靠,oracle pass@\(N\) 不会转化为实际准确率。
Self-consistency 与搜索
Self-Consistency 对多条 reasoning path 聚合答案;Tree of Thoughts 将生成、评估与回溯组织成树搜索。这些方法增加的是 test-time compute,应与单样本、相同总 token 和 oracle selector 基线同时报告。
搜索状态必须包含可重放的 prompt、已选动作、环境 observation、预算和终止原因。不同候选共享 prefix 时,还要避免缓存或随机状态串线。
Effort-conditioned policy
推理预算可以成为显式条件,而不只是把 max_tokens 调大。设 \(e\in\{\text{low},\text{high},\text{max}\}\),策略学习的是
训练和评测都应在同一问题上横向比较不同 \(e\) 的正确率、reasoning token、工具调用和 wall-clock。如果 high/max 只让文本更长而没有改善 verifier 通过率或恢复能力,模型学到的是 verbosity,不是可控计算。
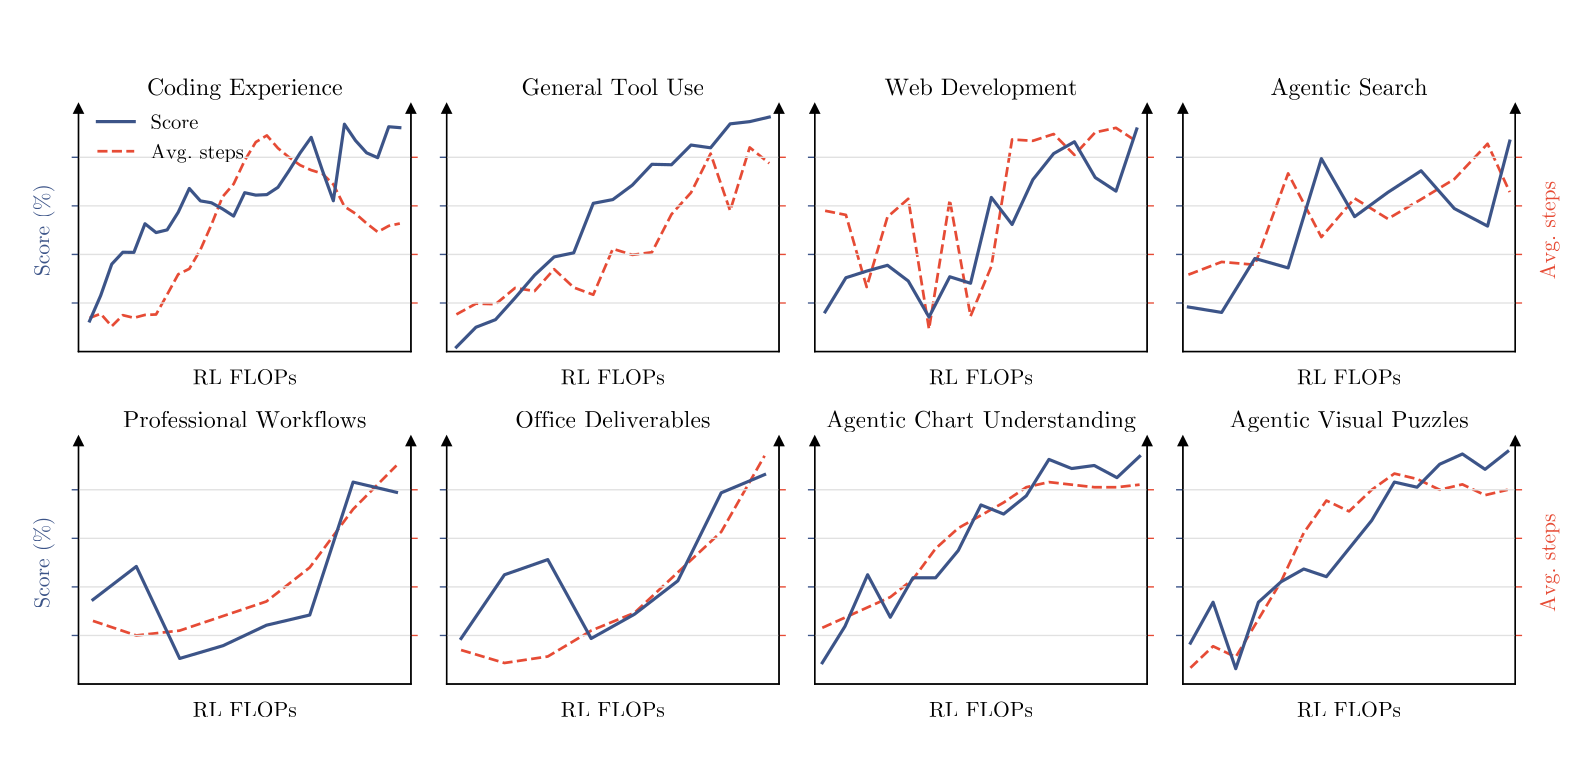
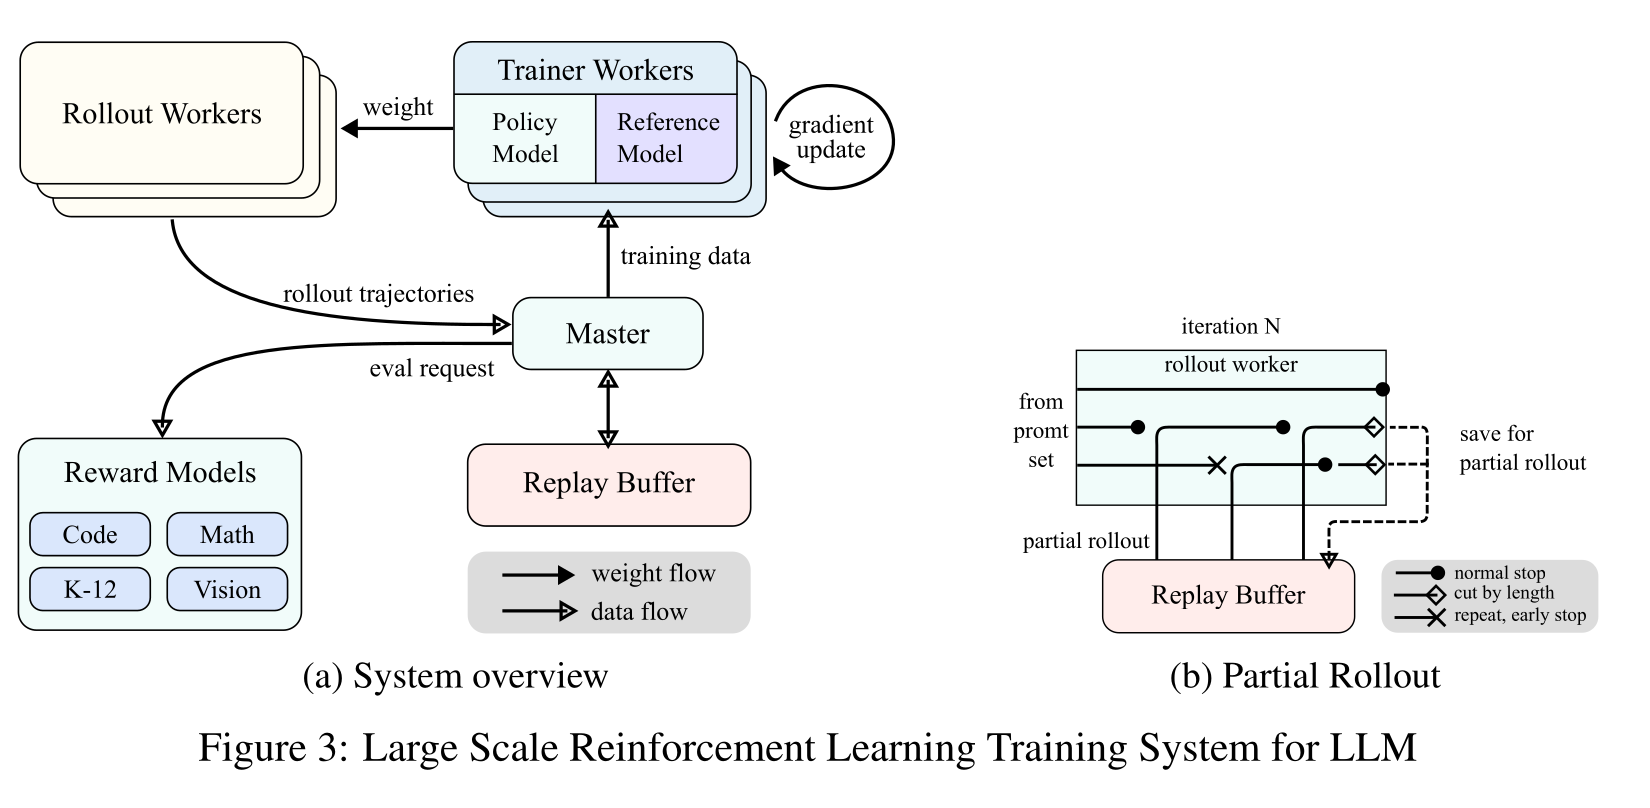
Kimi K3 技术报告把三档 effort 同时用于 RL teacher routing 与每题预算课程,形成了一项完整实例;其通用含义是把“能力—成本工作点”纳入策略接口。具体 teacher、阈值与预算没有完整披露,不能外推为固定 recipe。后训练与 serving 的衔接见 Kimi K3,预算惩罚和 partial rollout 见在线 RL。
Verifier
Outcome verifier
只判断最终答案,适合数学等式、代码测试、结构化状态和游戏终局。它成本低,但无法区分“方向正确但最后算错”和“全程错误却碰巧答对”。
Training Verifiers to Solve Math Word Problems 研究了生成多个解答并训练 verifier 选择答案。verifier 的准确率、候选覆盖与最终选择性能必须分开测量。
Process verifier
过程监督对步骤或前缀评分。Let's Verify Step by Step 展示了数学任务中的过程监督实验,OmegaPRM 研究了通过搜索自动收集过程监督。
过程标签需要明确:
- step 边界来自文本、token 还是环境 action;
- “当前步骤正确”是否表示仍可完成;
- 后续错误是否回写到此前步骤;
- 多种正确路径是否都被接受;
- 标签由人工、模型、rollout 还是形式工具产生。
局部正确不保证全局最优;PRM 分数也可能偏好固定分步格式。
从搜索到训练
搜索产生的对象可以转成不同监督:
| 搜索产物 | 训练接口 | 丢失的信息 |
|---|---|---|
| 最优完整轨迹 | SFT / sequence distillation | 候选概率与失败对比 |
| 成功与失败候选 | Pairwise preference | 细粒度步骤信用 |
| 每步标签 | Process reward / SFT mask | 全局搜索价值 |
| 最终可验证 reward | Online RL / RLVR | 未访问动作的信息 |
| 搜索树访问统计 | Policy/value target | 搜索器和预算偏差 |
一个稳健闭环是:
fresh tasks
  -> policy proposals
  -> search / execution
  -> independent verification
  -> trajectory dedup and failure taxonomy
  -> SFT / preference / process / RL objective
  -> budget-matched fresh evaluation
STaR 通过迭代生成与筛选 reasoning rationale 再训练模型,展示了搜索/自举到训练的早期路线。每轮都应保留原始任务和失败,避免只训练被当前模型容易解决的子集。
蒸馏与 RLVR
Teacher 或强搜索器可以生成成功轨迹,再蒸馏到 student;目标与 prefix 对齐问题见知识蒸馏。DeepSeek-R1 报告了可验证奖励 RL 与 reasoning distillation 的一组公开实验,DeepSeekMath 则描述了数学任务中的 GRPO 配方。
这些工作证明某些配方在特定数学、代码和模型设置中有效,不意味着:
- 所有开放任务都有可靠 verifier;
- 更长 rationale 总是更正确;
- group-relative 优势对任意 reward 分布都稳定;
- 从大模型蒸馏的行为在小模型上完整保留;
- benchmark 增益排除了数据污染与推理预算差异。
在线目标与退化组处理见在线 RL。
Curriculum 与成功饱和
若同一 prompt 的所有候选都成功或都失败,group-relative 方法没有相对信号。动态课程可把训练集中在当前策略成功率中间的任务,但会产生选择偏差:
- 过早丢弃困难任务,模型无法拓展能力边界;
- 反复生成相似中难题,覆盖收缩;
- 用同一 verifier 挑题和评测,投机被强化;
- 难度随模型变化,历史训练分布不可比较。
因此课程应同时保留:
- 固定锚点任务;
- 易、中、难和不可解切片;
- 失败原因与 verifier 状态;
- 每题族真实采样和 token 预算;
- 未参与课程选择的冻结评测。
长时与 Agent 推理
在工具或环境中,推理不只是一段文本,而是 observation、action、外部状态和权限组成的 trajectory。ReAct 展示了 reasoning 与 acting 的交错形式。此时 verifier 应检查环境终态与副作用,文本解释不能替代真实状态;详细契约见数据与环境与长时任务。
正确性与失效
- oracle pass@\(N\) 当实际性能:忽略选择器错误。
- 不同方法使用不同 token/工具预算:比较混入 test-time compute。
- 只保留成功轨迹:错误检测、恢复和校准能力被删除。
- verifier 与生成器共享漏洞:格式投机被当作正确推理。
- 过程标签错位:文本 step 与 token/action advantage 不一致。
- 长输出获得更多 reward:长度而非推理质量被强化。
- 搜索数据与测试同题族:改写后的污染仍存在。
- 全组同 reward 强行标准化:制造 NaN 或随机梯度。
- 课程只追当前中难题:尾部覆盖和历史可比性坍缩。
- 环境错误记作策略失败:模型学习基础设施噪声。
何时不应训练推理
若任务有确定性算法或工具且模型只需正确调用,应先实现工具与权限约束;若 verifier 无法判断核心质量,增加搜索和 RL 可能只放大代理指标。数据量很小或计算预算不足时,prompting、检索、Best-of-\(N\) 和高质量 SFT 是更清晰的基线。
验证
- 固定总生成 token、工具调用和 wall-clock,比较 greedy、sampling、Best-of-\(N\) 与搜索。
- 同时报 oracle coverage、verifier selection accuracy 和最终成功率。
- 在全新来源、时间和题族上评测,审计题目、答案、解释与 teacher 污染。
- 分开测最终答案、步骤判断、校准、长度、成本与失败恢复。
- 对 verifier 做格式扰动、隐藏测试、对抗样例和基础设施故障注入。
- 比较搜索即服务、搜索数据 SFT、偏好、过程监督与在线 RL 的独立增益。
- 对全成功、全失败和低方差 group 做显式退化测试。
- 保留固定难度锚点,并报告课程实际 token share 与重复暴露。
pass@\(k\)、judge、bootstrap 与污染工具见评测工具,搜索与 verifier 的更多算法见搜索、过程奖励与验证。