Attention Kernel
Attention kernel 的核心矛盾不是矩阵乘法不会算,而是 score 矩阵可能远大于片上存储。高性能实现需要在不物化完整 \(S_q\times S_k\) score 的前提下,保持与标准 softmax attention 一致的语义。
FlashAttention 深读从 IO complexity、online softmax 不变量和 blockwise reference 解释这次转折;它与模型结构中的 attention 定义相容,却改变了计算被搬运和重算的方式。
问题与成本
单层 attention 可写为
其中
MHA 的 score 和 value aggregation 合计约
FLOPs。朴素实现还会写出大小为 \(BA S_qS_k\) 的 score 或 probability tensor;长上下文时,这一中间量的 HBM 往返往往比算术本身更昂贵。
GQA 通过让多个 query head 共享 KV head 减少 KV projection 和 cache:
它不会把 query head 的 score 计算量同比例降为 \(A_{\mathrm{kv}}/A\),因此“KV 显存缩小”和“attention FLOPs 缩小”必须分开讨论。
Online softmax
对一行 score 的一个 block,维护:
- 当前最大值 \(m\);
- 指数和 \(\ell\);
- 未归一化加权输出 \(o\)。
新 block 的局部状态为 \((m_b,\ell_b,o_b)\),合并规则是
全部 block 处理完后输出
该递推支持任意分块顺序的精确 softmax 合并;“精确”指在相同浮点误差约束下实现同一数学 attention,并非 bitwise 等同于某个朴素 kernel。
全 mask 行需要单独契约。若所有 score 都是 \(-\infty\),则 \(m=-\infty\) 会导致未定义的减法;实现应返回约定的零输出或显式错误,而不是传播 NaN。
Blockwise reference
下面处理单条 query 的 score 行:scores 为 [S_k],values 为 [S_k,d],输出为 [d]。它逐块维护 \((m,\ell,o)\),不物化完整 probability;全 mask 行按本页约定返回零向量。
import torch

def online_attention(scores, values, block_size):
    if (scores.ndim != 1 or values.ndim != 2 or values.shape[0] != scores.numel()
            or scores.device != values.device or block_size <= 0):
        raise ValueError("scores and values must align on a positive blocked sequence")
    m = torch.tensor(float("-inf"), dtype=scores.dtype, device=scores.device)
    normalizer = torch.zeros((), dtype=scores.dtype, device=scores.device)
    numerator = torch.zeros(values.shape[-1], dtype=values.dtype, device=values.device)
    for start in range(0, scores.numel(), block_size):
        block = scores[start:start + block_size]
        value = values[start:start + block_size]
        if not torch.isfinite(block).any():
            continue
        block_max = block.max()
        weight = torch.exp(block - block_max)
        new_max = torch.maximum(m, block_max)
        old_scale, block_scale = torch.exp(m - new_max), torch.exp(block_max - new_max)
        numerator = old_scale * numerator + block_scale * (weight @ value)
        normalizer = old_scale * normalizer + block_scale * weight.sum()
        m = new_max
    return numerator / normalizer if normalizer > 0 else torch.zeros_like(numerator)

score = torch.tensor([1., -float("inf"), 3., -2., 0.])
value = torch.arange(15, dtype=torch.float32).view(5, 3)
expected = torch.softmax(score, dim=0) @ value
torch.testing.assert_close(online_attention(score, value, 2), expected)
assert torch.equal(online_attention(torch.full((5,), -float("inf")), value, 2), torch.zeros(3))
try:
    online_attention(score, torch.zeros(6, 3), 2)
except ValueError:
    pass
else:
    raise AssertionError("unmatched score and value rows must be rejected")
分块大小和遍历顺序可以改变,输出语义不应改变;mask 后的 \(-\infty\) 也不得污染状态。这个 Python reference 用于定义算法,不代表 GPU kernel:生产实现还需处理 batch/head、累加 dtype、causal tile 跳过、GQA 映射和 backward 重放。与朴素 softmax 的更多逐块对照见 Tensor 原语。
FlashAttention 的稳定基础
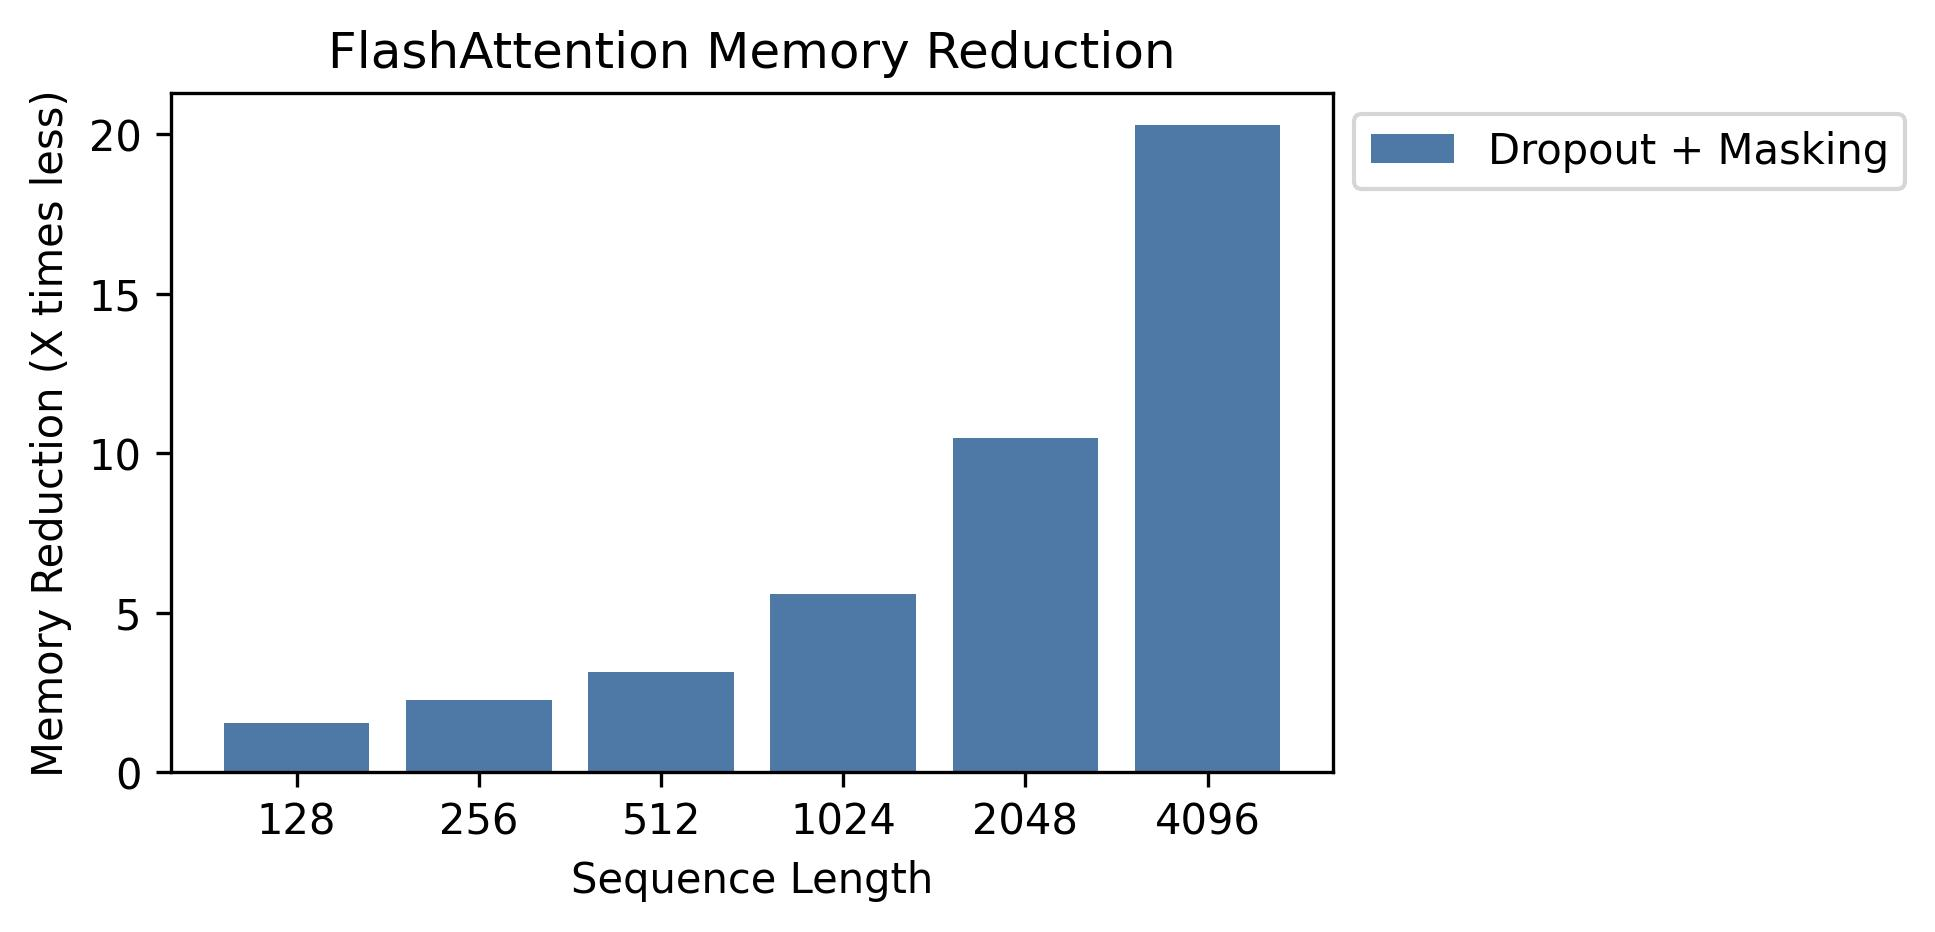
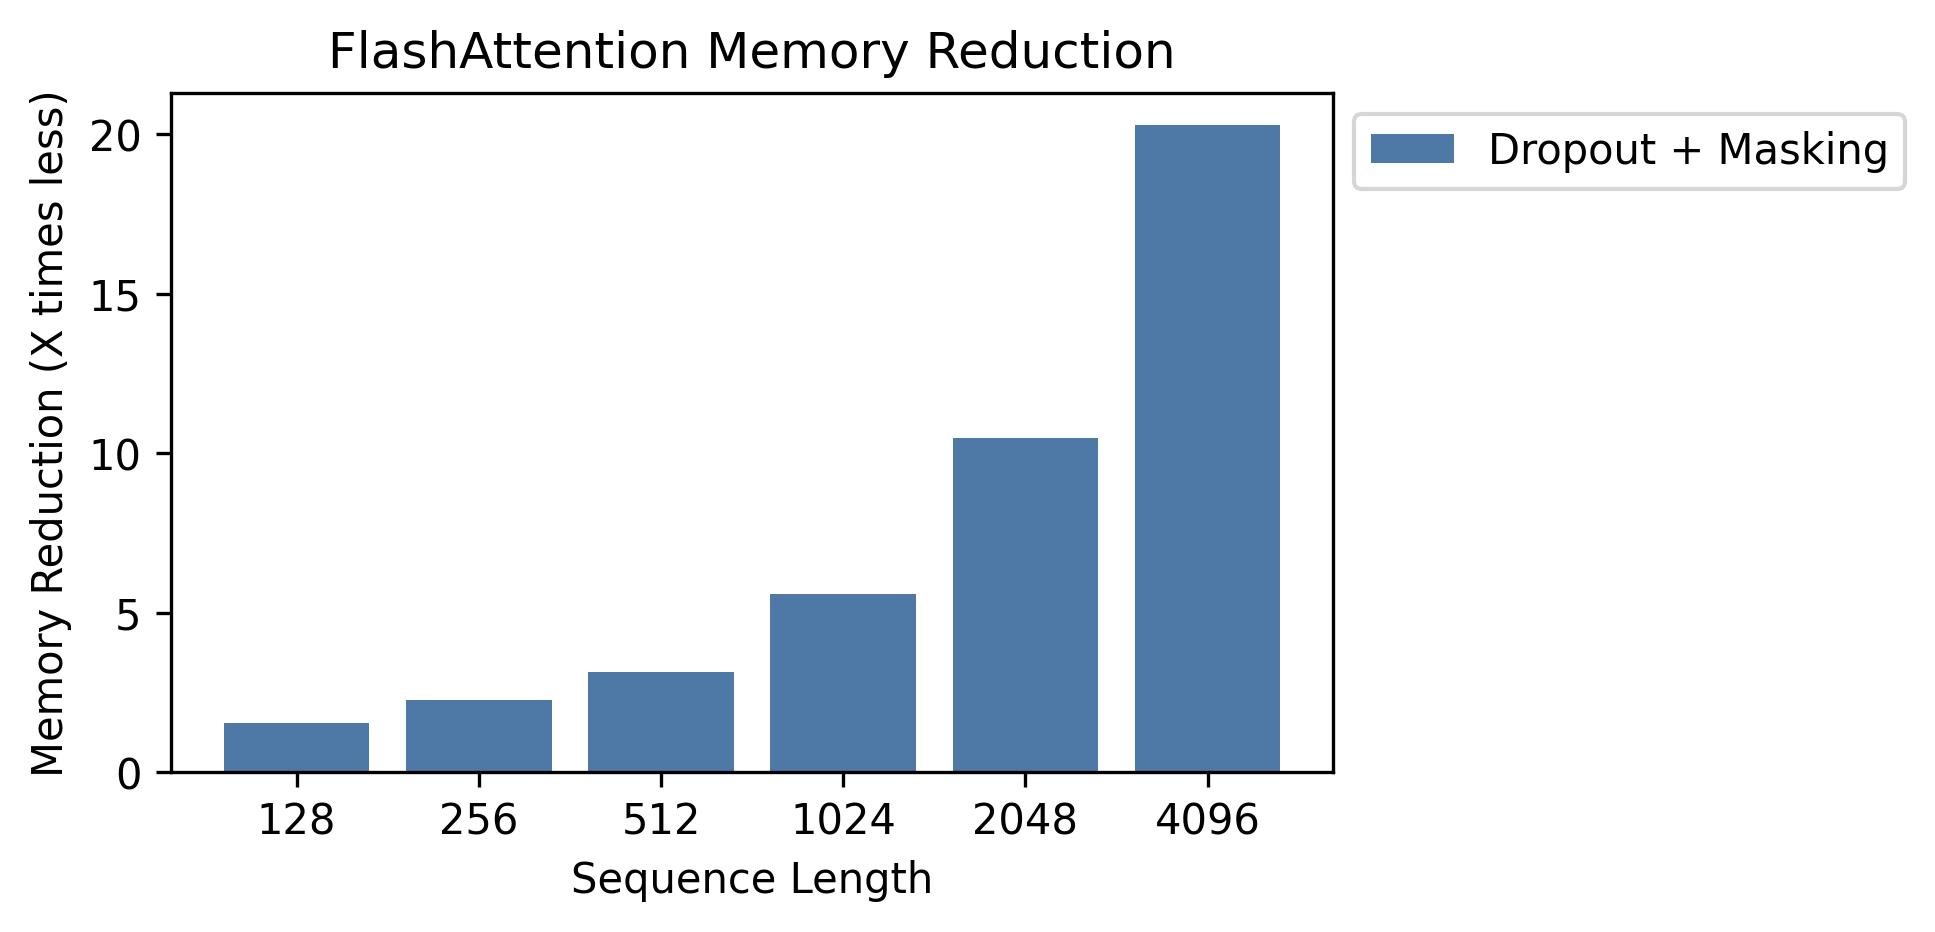
FlashAttention 把 \(Q\)、\(K\)、\(V\) 切成片上 tile,使用 online softmax 立即消费局部 score,从而避免将完整矩阵写回 HBM。它优化的是 IO,不是近似线性 attention。
FlashAttention-2 进一步减少非矩阵乘法工作,并调整 thread block 和 warp 的任务划分。两代工作的稳定结论是:
- attention 性能必须同时分析 FLOPs 与 HBM transaction;
- tile shape 由 head dimension、dtype、mask 和片上资源共同决定;
- forward 保存的 log-sum-exp 等统计决定 backward 的重算方式;
- causal mask 可跳过整块无效 tile,但边界 tile 仍需逐元素 predicate。
2024–2026 的硬件协同前沿
FlashAttention-3 针对 Hopper 引入 TMA、warp specialization,以及 GEMM、softmax 间更深的异步流水,并研究 FP8 路径。它证明了新硬件异步能力的重要性,但实现结论与 Hopper 的执行和存储机制紧密相关。
FlashAttention-4 进一步研究不对称硬件上算法流水与 kernel 调度的协同设计。截至 2026 年 7 月,它应作为前沿机制和论文证据介绍,不能被写成所有平台已经默认采用的稳定 API。
生产文档应分开三层:
- online softmax 与 IO-aware tiling 的算法不变量;
- 特定代际上的 TMA、warp specialization 和 Tensor Core 实现;
- 当前运行时实际可用的 kernel、shape 与精度范围。
官方实现与支持矩阵应以 FlashAttention repository 的具体版本为准。
线性 Attention 的 recurrent kernel
线性 attention 不物化 \(QK^\mathsf T\),但会引入沿序列推进的 recurrent state。以 gated state update 为例:
并行训练需要 chunk 内矩阵乘效率,长序列又需要跨 chunk 传递 \(S\);高性能 kernel 因此通常同时提供:
- recurrent 路径,适合短 query 或增量 decode;
- chunkwise 路径,把块内更新改写为大矩阵运算;
- backward 的状态重算或保存策略;
- gate 下界、累加 dtype 与边界 state 的固定语义。
Kimi Linear 公开了 Kimi Delta Attention(KDA)及其算法实现;FlashKDA 则是面向 CUTLASS 的官方 kernel 入口。Kimi K3 技术报告披露 K3 在 69 个 KDA 层中使用 gate 下界 \(g_{\min}=-5\),并保留 24 个 Gated MLA 层。这个下界和层数是模型语义,不能在 kernel 调优时更改;通用实现应把 recurrent/chunkwise 输出、梯度和极长序列数值漂移分别对齐。架构与系统如何配合见 Kimi K3。
压缩稀疏 Attention 的多段 Kernel
DeepSeek-V4 CSA 不是一个可由普通 FlashAttention 参数化完成的 kernel。一次 query 至少经过:
token compression
→ compressed indexer key
→ FP4 multi-head score
→ BF16 top-k selection
→ gather compressed KV + local SWA
→ shared-KV MQA
→ grouped output projection
压缩器逐 channel 对两个相邻块共 \(2m\) 个候选做 softmax;indexer 用多头 ReLU dot-product 的加权和排序;core attention 才使用被选中的 entry。任一阶段的 layout 改变都会传递到下一阶段,单独优化 score GEMM 可能被 top-\(k\)、gather 或 ragged MQA 吞掉。
V4 还要求 batch invariance:同一序列在不同 batch 组合中保持相同输出。短 attention 由单 SM 完成全序列,较长尾部才走多 SM,并固定 accumulation 语义;sparse backward 则让每个 SM 先写独立 buffer,再按确定顺序归约。代价是额外 buffer 与部分 shape 下放弃最快 split-K。完整系统取舍见 V4 系统闭环。
Prefill 与 decode 是两种 kernel
prefill 通常有较大的 \(S_q\),可形成较饱满的 GEMM tile;decode 常有 \(S_q=1\),需要读取长 KV:
decode 更容易受 KV 带宽、间接寻址和 launch 控制。适合 prefill 的大 tile kernel 不一定适合 decode;系统通常需要独立的:
- dense prefill attention;
- single-query 或 small-query decode attention;
- paged KV attention;
- variable-length / ragged attention;
- prefix reuse 或 tree verification attention。
FlashInfer 系统化讨论了 LLM serving 中 attention 的多形态 kernel 与调度问题;其官方实现可用于核对版本相关接口,而不是作为算法定义的唯一来源。
Paged 与 ragged KV
Paged KV 不要求一条序列的 cache 在物理内存连续。逻辑 token 位置 \(t\) 映射为
再通过 block table 找到物理 page。kernel 需要处理:
- 每条序列不同的 block table;
- 最后一个 page 的有效 token 数;
- shared prefix 与 copy-on-write;
- KV head 的 TP placement;
- cache dtype 和 scale metadata;
- 请求取消后的异步 page 生命周期。
间接寻址会减少连续性和预取机会,但避免了大规模连续预留和迁移。连续虚拟地址方案与 paged tensor 方案的机制差异见 vAttention 和 PagedAttention。
ragged batch 不应通过盲目 padding 恢复矩形。可使用 cumulative sequence length 描述每条序列的区间,但 offset dtype、空序列和跨边界访问都属于正确性契约。
可编程 mask
mask 可能包含 causal、sliding window、document boundary、prefix-LM 或块稀疏规则。把任意用户函数放进内层循环往往破坏 fusion 和 tile 跳过;更可行的分层是:
- block 级稀疏性决定哪些 tile 完全跳过;
- tile 内 score modifier 处理剩余逐元素规则;
- 编译 cache key 包含 mask 语义和 shape 类别。
PyTorch FlexAttention 提供了这类可编程 attention 的官方接口示例。其可表达性不保证任意规则都高效;mask 不能在 block 级剪枝时,性能可能接近 dense attention。
Backward 与重计算
若 forward 不保存 probability 矩阵,backward 需要利用 \(Q\)、\(K\)、\(V\)、输出和 log-sum-exp 重算局部概率。需要保证:
- forward 与 backward 使用相同的 softmax scale 和 mask;
- dropout RNG 可按 tile 和逻辑位置重放;
- packed sequence 的边界一致;
- GQA head 映射一致;
- 累加和原子写入没有 race;
- activation checkpoint 不重复推进 RNG。
重算增加 FLOPs,却可显著降低 HBM 流量。是否加速取决于原始路径是 compute-bound 还是 memory-bound。
正确性契约
attention kernel 至少固定:
- \(Q/K/V\) 的 shape、layout、stride 和 head 映射;
- \(S_q\)、\(S_k\)、causal offset 与位置编号;
- softmax scale、logit cap 和 score modifier 顺序;
- padding、window、document 与全 mask 行语义;
- input、accumulator、log-sum-exp 和 output dtype;
- dropout 概率、RNG seed、counter 和重放规则;
- page size、block table、有效 token 数与 cache quant schema;
- backward 保存或重算哪些状态;
- deterministic 和允许误差边界。
融合 RoPE、bias、alibi 或 quantized KV 时,这些变换的顺序也是可观察语义,不能为方便 kernel 而任意交换。
失效模式与何时不用
- head dimension 或 layout 不受支持:转换和 padding 可能抵消快路径收益。
- 序列太短:launch、调度和编译成本主导。
- 稀疏 mask 无块结构:索引开销大,无法跳过完整 tile。
- 跨页访问高度离散:decode 受 cache miss 和地址计算限制。
- register 或 shared memory 过量:tile 更大反而降低 resident block。
- 极低精度误差预算未知:先保留 BF16 / FP32 reference。
- 需要 attention probability 全矩阵:IO-aware streaming 路径可能不适合直接输出全部概率。
- 硬件代际不匹配:TMA 或特定 Tensor Core 路径不能移植为通用实现。
不能用论文中的单一长序列 benchmark 推断线上混合长度、分页 KV 与多租户调度的收益。
验证
- 与高精度 dense reference 对比标准、causal、window、packed 和 GQA。
- 覆盖 \(S_q=1\)、\(S_k=0/1\)、非 tile 倍数、全 mask 行和极长序列。
- 验证连续 KV 与随机 block table 得到相同结果。
- 对 forward、backward、dropout replay 和 activation checkpoint 分层测试。
- 比较绝对误差、log-sum-exp、梯度和下游任务质量。
- 记录实际 FLOPs、HBM/L2 transaction、occupancy、register、shared memory 和端到端占比。
- 分开报告 prefill、decode、不同 page size、长度分布和并发度。
- 在 graph capture、请求取消与 cache COW 后重复 correctness test,检查异步生命周期错误。
kernel 层结论应回到性能成本模型核对 Amdahl 上限,并与 GPU 执行模型中的 tile、流水和资源约束一起解释。
稀疏注意力的三段融合
GLM-5 的 Ascend 适配把 DSA 数据流拆成三条 kernel:
- Lightning Indexer 融合 score、ReLU 与 top-\(k\);
- Sparse Flash Attention 让 KV 选择与稀疏 attention 并行;
- MLAPO 把 13 个 MLA preprocessing operator 融成一个 super-operator。
优化边界恰好对应 index -> gather -> attention。只测第三段的 FLOPs/s 会漏掉 top-\(k\)、不规则地址和 gather;只测 indexer 又无法证明 end-to-end decode 加速。应在真实 KV 长度和 prefix-hit 分布下分别记录 index、gather、attention、launch、D2H 与 fallback 时间,并验证选中索引、mask 和 dense reference 的数值语义。
报告没有公开 kernel 源码和可重建 benchmark,性能与 \(50\%\) 成本声明属于特定系统结果。架构选择见 GLM-5 架构,部署组合见 GLM Agentic Engineering。
Reference
- FlashAttention
- FlashAttention-2
- FlashAttention-3
- FlashAttention-4
- Dao-AILab/flash-attention
- FlashInfer
- flashinfer-ai/flashinfer
- vAttention
- Kimi Linear
- FlashKDA
- Kimi K3 Technical Report
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DeepGEMM
- DeepSeek-V3.2 / DeepSeek Sparse Attention
- GLM-5: from Vibe Coding to Agentic Engineering