注意力家族
注意力架构同时决定表达能力、KV Cache 形状和服务带宽。比较 MHA、MQA、GQA 与低秩 KV 路线时,必须把训练计算和增量 decode 分开。
统一记号
设模型有 \(H_q\) 个 query head、\(H_{kv}\) 个 key/value head,每个 head 维度为 \(d_h\)。第 \(a\) 个 query head 使用映射 \(g(a)\) 找到对应 K/V head:
不同家族主要改变 \(H_{kv}\) 和 \(g\):
| 方法 | \(H_{kv}\) | 共享关系 | 主要权衡 |
|---|---|---|---|
| MHA | \(H_q\) | 每个 Q 独立 K/V | 容量高,缓存最大 |
| MQA | \(1\) | 所有 Q 共享 K/V | 缓存最小,可能损失质量 |
| GQA | \(1<H_{kv}<H_q\) | 每组 Q 共享 K/V | 质量与带宽折中 |
GQA 还给出从 MHA checkpoint uptrain 的路线,说明架构选择既可以从头训练,也可以通过受控转换获得。
最小语义实现
grouped_query_attention 接收 q:[B,H_q,T_q,D] 与 k,v:[B,H_{kv},T_k,D],把连续的 \(H_q/H_{kv}\) 个 query head 映射到同一 KV head。它还显式处理 suffix decode:当 \(T_q<T_k\) 时,query 的逻辑位置从 \(T_k-T_q\) 开始,而不是套用错位的方阵 mask。
import math
import torch

def grouped_query_attention(q, k, v):
    batch, query_heads, query_len, dim = q.shape
    _, kv_heads, key_len, _ = k.shape
    assert query_heads % kv_heads == 0 and query_len <= key_len
    repeat = query_heads // kv_heads
    k = k.repeat_interleave(repeat, dim=1)
    v = v.repeat_interleave(repeat, dim=1)
    score = q @ k.transpose(-1, -2) / math.sqrt(dim)
    query_pos = torch.arange(key_len - query_len, key_len, device=q.device)
    key_pos = torch.arange(key_len, device=q.device)
    future = key_pos[None, :] > query_pos[:, None]
    score.masked_fill_(future, -torch.inf)
    probability = torch.softmax(score.float(), dim=-1).to(q.dtype)
    return probability @ v

torch.manual_seed(0)
q = torch.randn(2, 4, 5, 8)
k, v = torch.randn(2, 2, 5, 8), torch.randn(2, 2, 5, 8)
full = grouped_query_attention(q, k, v)
step = grouped_query_attention(q[:, :, -1:], k, v)
assert full.shape == q.shape
torch.testing.assert_close(step, full[:, :, -1:])
mapping_q = torch.zeros(1, 4, 1, 1)
mapping_k = torch.zeros(1, 2, 1, 1)
mapping_v = torch.tensor([[[[1.]], [[7.]]]])
mapped = grouped_query_attention(mapping_q, mapping_k, mapping_v)
assert mapped.flatten().tolist() == [1., 1., 7., 7.]
这里的 repeat_interleave 只用于说明 head 映射,会真实复制 K/V;生产 kernel 应在不复制缓存的前提下完成分组寻址,并另行接入 padding、packed segment、RoPE、dropout 与低精度策略。逐张量实现见张量原语:Grouped-Query Attention,完整 block 的 mask 组合见 Decoder-only Transformer:Attention。
KV Cache 成本
对 \(L\) 层、batch \(B\)、缓存长度 \(T\) 和每元素 \(s\) 字节,
decode 每步还要读取历史 K/V,因此减少 \(H_{kv}\) 同时降低容量和带宽压力。prefill 仍需处理完整注意力矩阵,收益不一定与 cache 缩减比例相同。
Multi-head Latent Attention
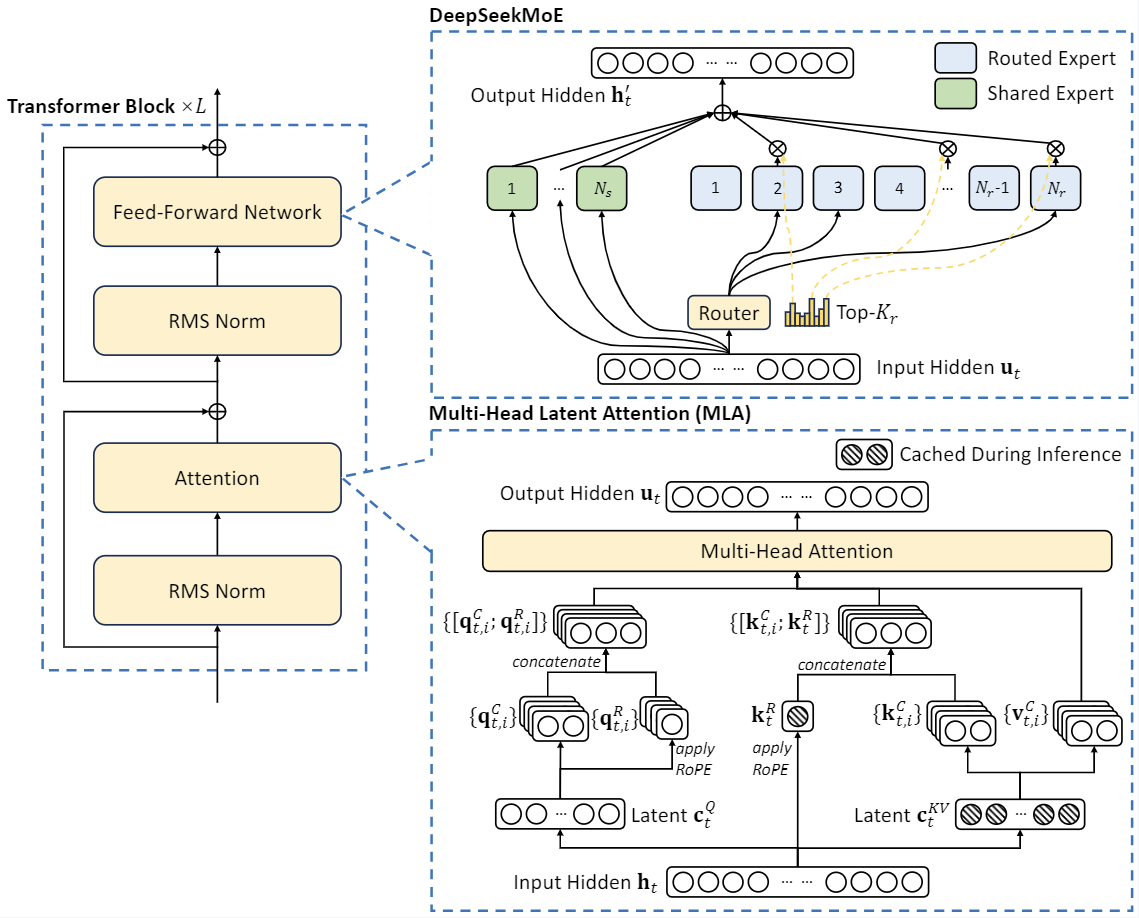
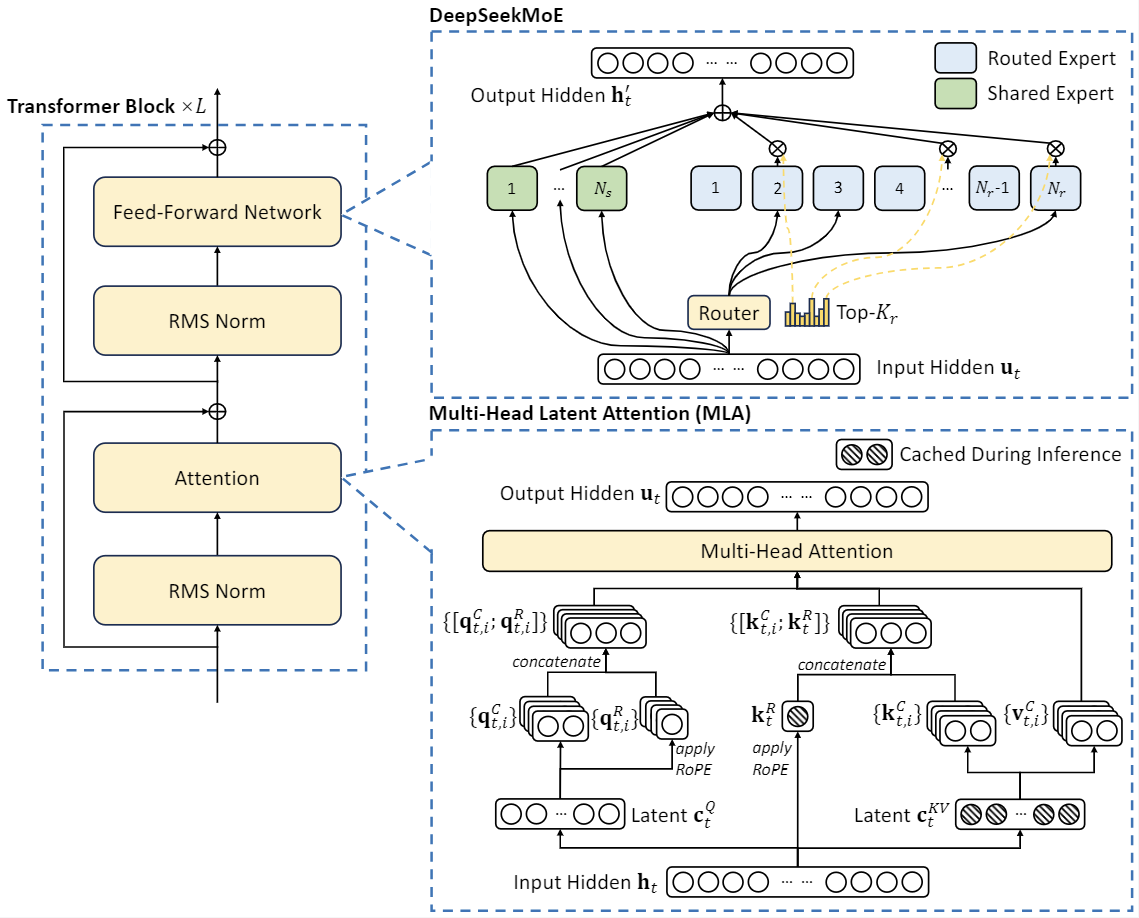
低秩 KV 路线不直接缓存展开后的每个 K/V head,而是先把隐藏状态压缩为潜变量:
再恢复内容相关的 key 与 value:
DeepSeek-V2 中的 Multi-head Latent Attention 把这条路线与可单独缓存的位置分支组合。它的价值不只来自低秩分解,还取决于推理时能否将部分投影吸收到 query 或输出计算中,避免每步显式恢复大 K/V 张量。
权重吸收的边界
若注意力 score 中出现
可在满足线性与布局条件时改写为
这类矩阵结合能把一部分上投影从历史 token 侧移到当前 query 侧。但 RoPE 之类位置相关变换通常不能任意穿过低秩投影;位置分支、量化 scale 和并行分片也会限制吸收方式。理论 cache 大小只有落到 kernel 和张量布局后才成为实际收益。
Gated MLA 与混合注意力
MLA 解决的是“全局注意力怎样减少历史缓存”,线性注意力解决的是“怎样用有限状态替代随长度增长的 历史”。两者不是互斥选项。Kimi Linear 与 Kimi K3 技术报告给出一种 层间混合:大多数层使用 KDA 递推,周期性插入 MLA,让 token 仍能对全局历史作精确、内容相关寻址。 K3 的一个 block 是 3 层 KDA 加 1 层 Gated MLA,并让主干最后一层仍为 Gated MLA。
这组设计把职责拆开:
- KDA 以固定大小 state 提供位置敏感、带 recency bias 的传播;
- MLA 用低维 latent cache 保留不受局部窗口限制的全局内容交互;
- 周期性 full attention 修补有限状态在精确召回和 key 冲突上的结构性弱点;
- 混合比例则在状态计算、KV bytes、全局寻址频率与 kernel 成熟度间取舍。
K3 的 MLA 层不对 \(Q,K\) 施加显式位置编码(NoPE)。这并不表示整个模型没有顺序信息:作者把顺序和 新近性主要交给层间穿插的 KDA recurrence,而让 MLA 专注全局内容匹配。这样的 NoPE 结论依赖混合 主干,不能脱离 KDA 复制到纯 MLA 模型,也不能仅凭“无需调整 RoPE”推导任意长度上的有效利用能力。
在 ungated MLA 输出 \(\tilde o_t\) 后,K3 增加 full-rank、逐通道输出门:
full-rank 指 \(W_g\) 直接从 hidden width 映射到输出通道,不先经过小 bottleneck。它让每个 token 决定全局读出的哪些通道进入 residual stream,但不改变 MLA 的 attention probability 或 cache 形状。报告还说明训练时保留 FP32 attention output,以缓解 flash-attention 输出的 biased rounding; 这是训练 kernel 的精度与片上存储选择,不能从公式中省略后仍宣称数值路径等价。
Full-rank output gate
下面固定“先按输入生成 channel gate,再做输出投影”的顺序。零 gate projection 时 sigmoid 恰为 \(1/2\);若 output projection 为恒等映射,结果应是 attention output 的一半。
import torch
import torch.nn.functional as F

def gated_attention_output(x, attention_output, gate_weight, output_weight):
    assert x.shape == attention_output.shape
    width = x.size(-1)
    assert gate_weight.shape == output_weight.shape == (width, width)
    gate = torch.sigmoid(F.linear(x.float(), gate_weight.float()))
    output = F.linear(gate * attention_output.float(), output_weight.float())
    return output.to(x.dtype), gate

x = torch.randn(2, 5, 8)
attention_output = torch.randn_like(x)
output, gate = gated_attention_output(
    x, attention_output, torch.zeros(8, 8), torch.eye(8),
)
torch.testing.assert_close(output, attention_output / 2)
torch.testing.assert_close(gate, torch.full_like(gate, .5))
assert output.shape == x.shape
模型级实现还要补齐 latent projection 的权重吸收、NoPE 位置约定、causal/padding mask、FP32 输出 buffer、head layout 与增量 cache。混合架构的整体信息流见 Kimi K3,KDA 的递推真值见 状态空间与线性注意力。
从 DSA 到 CSA / HCA:先压缩时间轴,再决定怎样访问
DeepSeek-V3.2 的 DSA 用 Lightning Indexer 为 query 选择少量历史 KV;历史本身仍按 token 增长。DeepSeek-V4 再加入两种时间压缩路径:
| 路径 | 压缩步幅 | 长历史访问 | 局部补偿 |
|---|---|---|---|
| CSA | \(m=4\) | 压缩项上做 indexer top-\(k\) | SWA 128 |
| HCA | \(m'=128\) | 对全部重压缩项做 dense MQA | SWA 128 |
CSA 的每个输出从相邻两块共 \(2m\) 个候选做逐 channel softmax 加权,但相邻输出共享其中一块,所以输出长度仍约为 \(T/m\)。Lightning Indexer 先以多头 ReLU dot-product 评分,只把已完整闭合、因果可见的 compressed entries 交给 core attention。HCA 则不重叠压缩,也没有 top-\(k\):它用更强的 \(128\times\) 时间压缩换取便宜的全局 dense 通道。
两者都让一个 compressed entry 同时充当共享 key 与 value,query heads 仍可不同;还共同使用:
- query 与 compressed KV 的逐 head RMSNorm;
- head 尾 64 维 partial RoPE,以及输出上的负位置旋转;
- learnable attention sink,让某个 head 可以把总注意力质量压到 1 以下;
- grouped low-rank output projection,避免 \(H_qd_h\to d\) 的直接大投影;
- 未压缩 SWA,覆盖当前未闭合块和局部细节。
因此它既不是 MLA 的单纯低秩 channel compression,也不是固定状态的 linear attention。公式、因果边界与最小实现见 CSA / HCA 深读;heterogeneous cache 见 V4 系统闭环。
Mask 与增量位置
attention 实现至少同时处理:
- causal mask;
- padding 或 packed segment mask;
- sliding-window 或局部—全局 pattern;
- prefix-LM 的双向前缀;
- 增量 decode 中 query 长度与 cache 长度不同;
- 多模态 token 或工具 span 的结构约束。
一个常见错误是用方阵上三角 mask 处理 \(T_q\ne T_k\) 的增量输入,导致 query 对历史位置错位。应根据绝对 position 或 cache offset 构造语义,而不是依赖张量恰好为方阵。
选择框架
| 场景 | 首要问题 |
|---|---|
| 从头预训练 | 质量、训练稳定性与目标部署共同决定 head 结构 |
| 改造已有 checkpoint | 权重聚合、短期 uptraining 与回归成本 |
| 长上下文服务 | KV bytes/token、读取带宽与 cache 并发 |
| 量化部署 | K/V 或潜变量的误差传播与 scale 粒度 |
| Tensor Parallel | Q/K/V head 能否均匀分片,是否需要复制 |
| Prefix cache | cache key、position 与 adapter 是否完全兼容 |
位置机制见长上下文,缓存管理见 KV Cache,IO 优化见 Kernel 与性能。
MLA、DSA 与共享索引器
GLM-5 延续 DeepSeek-V2 的 Multi-head Latent Attention(MLA),但把单头维度扩大到 \(256\) 并减少 head 数,以保持参数与训练计算大致不变,同时降低 decode 阶段的 head 相关开销。报告中的精确配置是 64 个 attention heads,query 的非 RoPE / RoPE 维度为 \(192/64\),value 维度为 \(256\),KV LoRA rank 为 \(512\)。
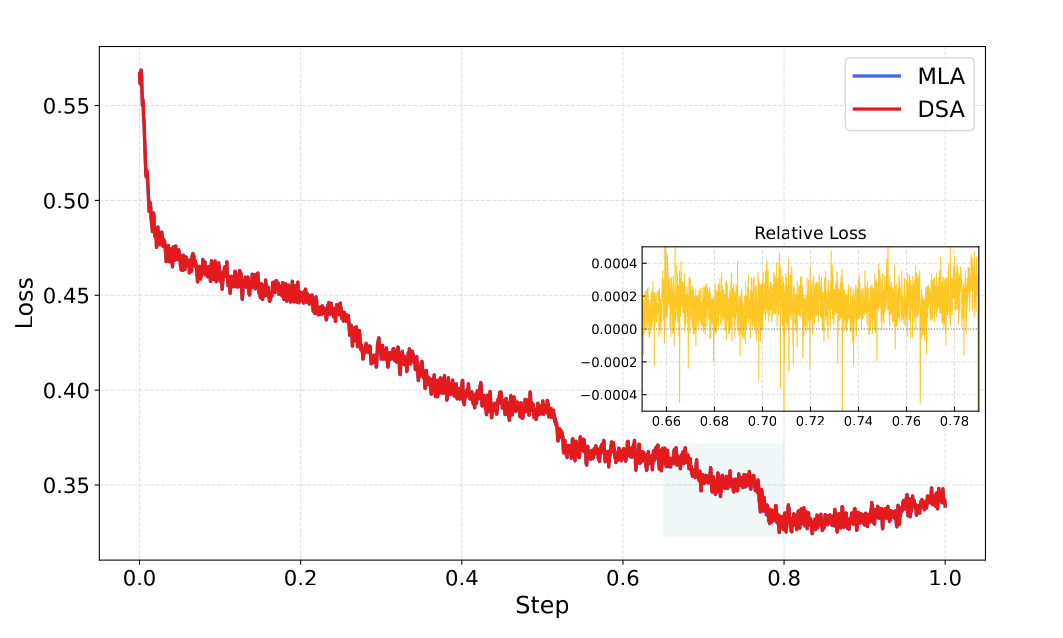
长上下文部分使用 DeepSeek Sparse Attention:轻量 indexer 先为历史位置打分,保留 top-\(2048\),再只对选中 KV 做 attention。GLM-5 在 mid-training 末段先用 1000 steps 训练 indexer,再用 20B tokens 做 sparse adaptation。论文称其“lossless by construction”应理解为作者对训练设计与实验范围的表述,不是 sparse output 与 dense attention 对所有输入严格相等。
GLM-5.2 把成本继续沿层轴压缩:官方配置显示每四层共享一组 indexer,称为 IndexShare;这与 GLM-5 每层独立 indexer 不是同一结构。缓存、共享与逐层误差传播见 IndexCache 与 IndexShare,完整参数口径见 GLM-5 架构。
Reference
- Attention Is All You Need
- Fast Transformer Decoding: One Write-Head is All You Need
- GQA: Training Generalized Multi-Query Transformer Models
- DeepSeek-V2
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Kimi K3 Technical Report
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- GLM-5: from Vibe Coding to Agentic Engineering
- GLM-5.2 官方配置