MoE 系统
Mixture-of-Experts 以稀疏激活换取更大的参数容量:每个 token 只进入少数 expert,而不是执行全部 FFN。系统难点随之从单个大 GEMM 转移到路由、计数、token permutation、all-to-all、多个不规则 GEMM 和结果归并。
MoE 是否更快取决于有效 batch、expert placement、网络和负载平衡,不能只比较“总参数量”和“激活参数量”。
路由与容量
设一个 MoE 层有 \(E\) 个 experts,每个 token 选择 top-\(k\)。router logits 为 \(r_{t,e}\),一种基本权重是
只保留 top-\(k\) expert 后,可选择对保留权重重新归一化。是否归一化、router dtype、tie-breaking 和 capacity 溢出策略都属于模型语义。
对 \(N_t=BS\) 个 token,capacity factor 为 \(\phi\) 时,每个 expert 的容量常写为
\(\phi>1\) 提供负载余量,却增加 padding 和显存;容量不足时若直接丢 token,会改变模型函数。无 token drop 的训练仍需为最坏或尾部负载准备动态 buffer。
可用负载不平衡比衡量尾部 expert:
其中 \(n_e\) 是分配给 expert \(e\) 的 token 数。平均负载平衡不能保证最大 expert 不阻塞整个 collective。
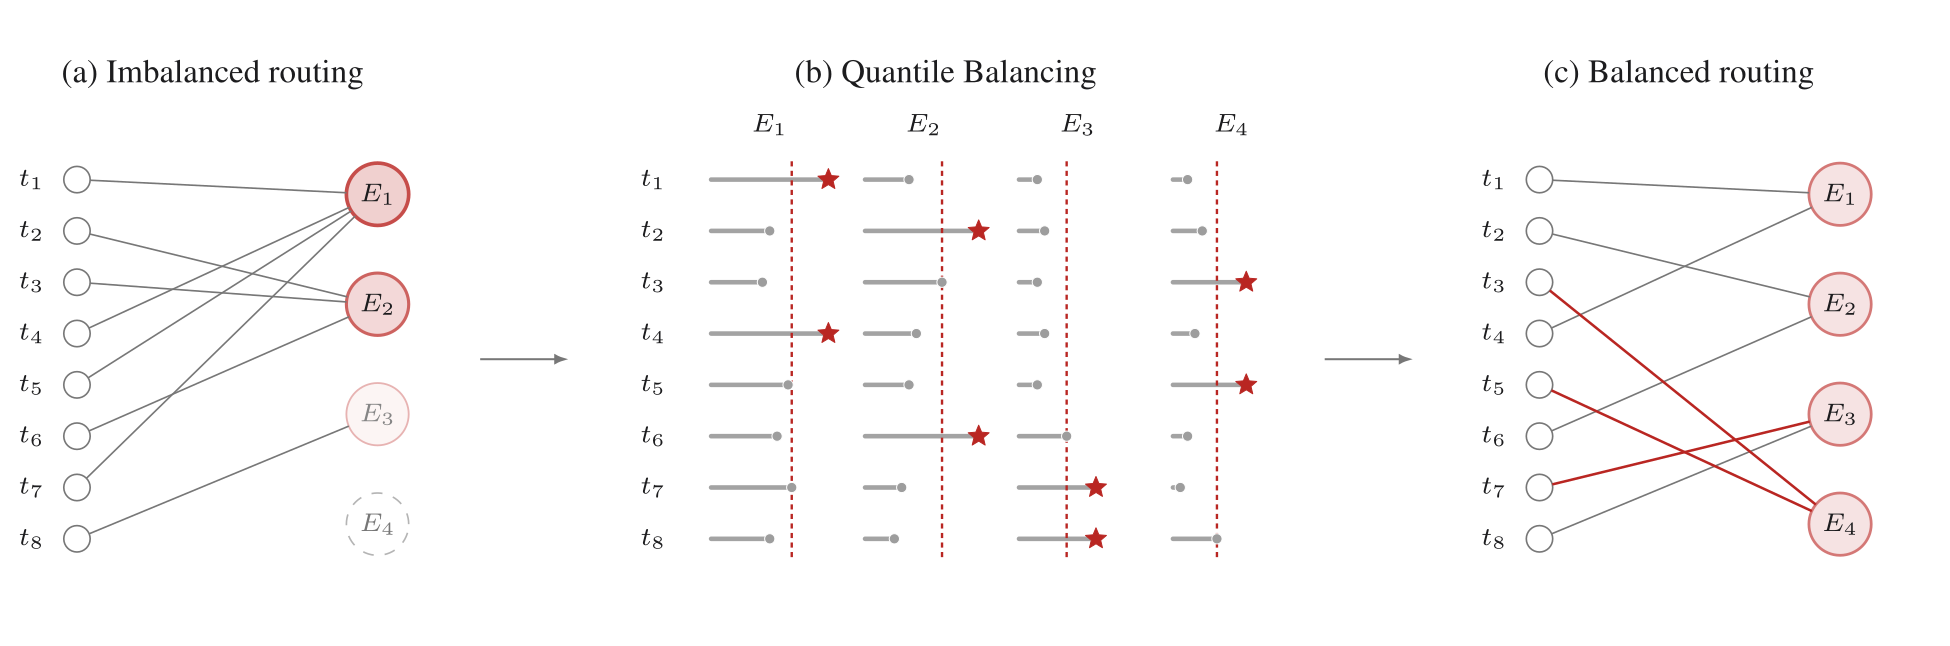
一次 MoE forward 的数据流
稳定实现通常包含:
- 计算 router logits 与 top-\(k\);
- 对 expert ID 做 histogram;
- 对计数做 prefix sum,得到每个 expert 的连续区间;
- 将 token 按目标 expert permutation;
- 跨 rank dispatch;
- 对本地 expert 执行 grouped 或 block-sparse GEMM;
- 跨 rank combine;
- 使用原始 token 索引和路由权重归并结果。
第 2–4 步不是普通 GEMM。它们涉及 reduction、scan、动态地址和 scatter;小 batch 下可能比 expert GEMM 更突出。
路由、执行与归并
下面的 x 为 [tokens,hidden],router logits 为 [tokens,experts],expert 权重为 [experts,out,hidden]。reference 对 top-\(k\) 权重重新归一化;capacity=None 时无 token drop,正整数 capacity 则按 routing rank、token 顺序截断,再把结果加权归并到原 token 顺序。
import torch
import torch.nn.functional as F

def moe_reference(x, router_logits, expert_weights, top_k, capacity=None):
    if x.ndim != 2 or router_logits.ndim != 2 or expert_weights.ndim != 3:
        raise ValueError("expected x [N,H], router [N,E], experts [E,O,H]")
    tokens, hidden = x.shape
    expert_count, output_size, expert_hidden = expert_weights.shape
    if router_logits.shape != (tokens, expert_count) or expert_hidden != hidden:
        raise ValueError("token, hidden, or expert dimensions disagree")
    if not isinstance(top_k, int) or not 1 <= top_k <= expert_count:
        raise ValueError("top_k must select existing experts")
    if capacity is not None and (not isinstance(capacity, int) or capacity <= 0):
        raise ValueError("capacity must be a positive integer")
    probability = torch.softmax(router_logits, dim=-1)
    gate, expert_id = probability.topk(top_k, dim=-1)
    gate = gate / gate.sum(dim=-1, keepdim=True)
    output, counts = x.new_zeros(tokens, output_size), torch.zeros(expert_count, dtype=torch.long)
    for slot in range(top_k):
        for expert, weight in enumerate(expert_weights):
            selected = expert_id[:, slot] == expert
            if selected.any():
                token = torch.where(selected)[0]
                if capacity is not None:
                    token = token[:max(capacity - counts[expert].item(), 0)]
                output[token] += gate[token, slot, None] * F.linear(x[token], weight)
                counts[expert] += token.numel()
    return output, counts

x, router = torch.randn(5, 4), torch.randn(5, 3)
identity_experts = torch.eye(4).repeat(3, 1, 1)
y, counts = moe_reference(x, router, identity_experts, top_k=2)
torch.testing.assert_close(y, x)
assert counts.sum().item() == 2 * x.shape[0] and counts.shape[0] == identity_experts.shape[0]
try: moe_reference(x, torch.randn(5, 4), identity_experts, top_k=2)
except ValueError: pass
else: raise AssertionError("router/expert mismatch must fail")
无容量截断时,每个 token 恰好产生 \(k\) 条路由记录,gate 和为 \(1\),归并后回到唯一逻辑位置;错配的 router expert 维会在路由前失败。生产实现把中间记录 permutation 后交给 all-to-all / grouped GEMM;tie-breaking、跨 rank split、低精度累加和 backward collective 必须额外固定,不能由这个单进程 reference 推断。
若每个 token 的 hidden activation 为 \(H\) 个、元素字节数为 \(s\),dispatch 与 combine 的逻辑 payload 数量级为
真实跨节点流量还应乘以远端 expert 比例,并计入 metadata、padding、协议和反向传播。expert placement 能显著改变这个比例。
Expert parallel 与 placement
expert parallel 将不同 experts 放到不同 rank。global expert ID 到
的映射必须版本化并写入 checkpoint。改变 EP size 时需要重新映射 expert shard,而不能把旧 local index 当作全局身份。
placement 的目标不只是一致分配参数,还包括:
- 热 expert 是否集中到同一节点或 NIC;
- 每 rank 的 token 数和 GEMM shape;
- 节点内、节点间带宽差异;
- TP 与 EP process group 是否正交;
- expert replica 是否允许热点扩散;
- 故障或扩缩容时怎样保持模型版本一致。
把高通信量 all-to-all 留在节点内可能需要用更多 PP / DP 维度跨节点;这是一项 topology-aware 的多维并行选择。
All-to-all 不是免费重排
all-to-all 的每个 rank 都向其他 rank 发送不同片段。若 token 分布动态,send split 和 recv split 也随 step 变化。正确流程需要先交换计数或使用有界容量布局。
通信时间可粗略写为
通信与 expert GEMM 的重叠只有在接收到一个可执行 chunk 后才能开始。过小 chunk 增加启动和调度开销,过大 chunk 又缩短重叠窗口。
DeepEP 提供了面向 MoE dispatch / combine 的官方实现,并区分训练吞吐与低延迟推理路径。它依赖具体互联、buffer 和通信语义,应按版本核对支持范围。
精确 rank 平衡与冗余 expert
仅让全局 expert token 数接近均匀,仍可能把热门 expert 的通信和 GEMM 集中到少数 rank。可以为部分 expert 放置动态冗余副本,再在不改变 top-\(k\) expert identity 的前提下,把路由记录分配给不同 replica,使每个 rank 接收恰好相同数量的 token。
MoonEP 深读从分配约束、online GPU plan、zero-copy/static buffer 和梯度归并还原了这条路线;其官方仓库提供当前实现入口。Kimi K3 技术报告描述的算法为每个 rank 限制至多约 \(E/R\) 个冗余 expert,并求一个紧近似的 replica allocation;数据面再使用 zero-copy buffer、静态通信 shape 与 workload-aware GEMM。这里必须分清:
- top-\(k\) 的 global expert 选择属于模型语义;
- 在同权重 replica 间选 owner 属于系统调度;
- replica weight 版本、optimizer update 和 checkpoint 映射必须一致;
- “每 rank token 数相等”不保证 NIC 路径、expert shape 和 GEMM 时间相等。
因此验证既要做 token 守恒和 logits 对齐,也要报告每 rank dispatch bytes、GEMM tile 数、尾延迟与副本同步开销。K3 中的整体并行布局见 Kimi K3。
Grouped 与 block-sparse GEMM
每个 expert 收到的 token 数 \(M_e\) 不同。逐 expert 启动 GEMM 会产生大量小 kernel;padding 到统一 capacity 又浪费计算。
grouped GEMM 把多个
问题交给一次协调调度。挑战是不同 \(M_e\) 的 tile 数不均、权重地址不同,以及小 expert 无法填满 Tensor Core。
MegaBlocks 使用 block-sparse 计算避免因容量 padding 丢弃 token,并让稀疏结构映射到块级矩阵运算。它证明“无 token drop”可以与高效 kernel 共存,但实际收益取决于 block size、路由分布和硬件。
grouped 与 block-sparse 是两种实现策略,不改变 router 和归并的模型语义。切换 kernel 时应保持 token-expert assignment、权重与输出顺序一致。
MegaMoE:以 expert wave 形成三段流水
DeepSeek-V4 不只把 dispatch 与 Linear-1、Linear-2 与 combine 两两重叠,而是把 expert 切成更小 wave。稳态时上一 wave 回传结果、当前 wave 做两次 GEMM、下一 wave 拉取 activation 同时发生;某一 wave 的 token 到齐即可启动,不等待整层。
若每个 token–expert pair 的计算为 \(6hd\) FLOPs,FP8 dispatch 与 BF16 combine 共 \(3h\) bytes,则通信可完全隐藏的理想阈值为
V4-Pro 的 expert intermediate \(d=3072\),因而对应 6144 FLOPs/Byte。这个 balance point 会随 dtype、实际 GEMM 利用率、拓扑和 power throttling 改变。报告相对其非融合基线测得一般推理 \(1.50\text{–}1.73\times\)、延迟敏感场景最高 \(1.96\times\);公开 CUDA 实现进入 DeepGEMM PR #304。完整系统语义见 MegaMoE、TileLang 与 DSec。
负载平衡与模型质量
常见辅助目标通过 expert 使用频率和平均 router probability 抑制塌缩,但过强约束会改变模型学习目标。系统层还可使用:
- capacity factor;
- token dropping 或 overflow expert;
- expert replication;
- 动态 placement;
- microbatch 合并;
- 路由 bias 或局部性约束。
这些机制不能只按吞吐评价。路由决策改变会影响模型输出;expert replication 若副本权重不同步,也会直接破坏正确性。DeepSeek-V3 披露了 auxiliary-loss-free balancing、节点受限路由和训练系统的组合设计,适合作为 2024 年末的大规模实例,而非所有 MoE 的默认配置。
与 TP、DP、PP、CP 组合
设 world size 为
这只是网格规模约束。还需定义每个 tensor 的 placement:
- dense attention 权重可能按 TP 切分;
- expert 权重按 EP 切分,并可在 DP 组复制;
- sequence 可按 CP 切分;
- router 参数可能复制或单独切分;
- expert gradient 的 reduction group 与 dense 参数不同。
错误复用同一 process group 会产生重复 reduction、漏同步或 collective 顺序冲突。Megatron Core MoE 指南提供了组合并行的官方语义和当前特性边界。
推理中的 MoE
训练追求大 token batch 和稳定吞吐;在线 decode 的每步 token 少、分布动态,更容易产生 skinny expert GEMM 和网络尾延迟。
推理优化可能包括:
- 跨请求 continuous batching;
- hot expert replication;
- 节点内优先路由;
- dispatch / compute overlap;
- 分离 prefill 与 decode 的通信配置;
- 对小 expert 使用 persistent 或 grouped kernel。
复制 expert 增加权重显存,并需要明确副本选择、版本更新和 cache / graph 兼容性。为了局部性强制改变 top-\(k\) 结果属于模型近似,不能伪装成纯系统优化。
正确性契约
MoE 层至少固定:
- router 输入 dtype、softmax、top-\(k\)、tie-breaking;
- top-\(k\) 后是否重新归一化;
- capacity、padding、overflow 与 token-drop 语义;
- global expert ID、placement、replica 与 checkpoint 映射;
- permutation 和 inverse permutation;
- dispatch send/recv split 与 metadata dtype;
- expert GEMM 的输入区间、权重版本和输出顺序;
- combine 的加权与 reduction 精度;
- empty expert、重复 expert ID 和 zero-token rank 行为;
- forward / backward collective 顺序与 stream 生命周期。
每个输入 token 在 dispatch 后应能追踪到恰好 \(k\) 个目标记录,并在 combine 后归并回唯一逻辑位置。若允许 drop,应可观察且进入质量统计。
失效模式与何时不用
- token batch 太小,router、permutation 和 all-to-all 比 expert GEMM 更贵;
- 网络跨节点带宽不足或尾延迟高;
- expert 热点长期集中,最大 rank 决定 step time;
- capacity padding 抵消稀疏计算收益;
- TP 把 expert GEMM 再切得过小;
- expert mapping 与 checkpoint / serving 版本不一致;
- 动态路由导致 graph capture 和内存预留失效;
- 模型规模并不需要稀疏容量,dense 模型更简单可靠。
MoE 的理论激活 FLOPs 较低,不代表相同质量、相同延迟或相同部署成本。小规模或低并发服务应先比较 dense baseline。
验证
- 在单 rank 验证 router、permutation、expert 计算和 inverse permutation。
- 构造所有 token 去同一 expert、均匀分布、空 expert、tie 和 capacity overflow。
- 对比 EP=1 与多 rank 输出、梯度和 expert 更新。
- 检查每 rank send/recv split 总和、全局 token 守恒和 collective 顺序。
- 分别记录 router、permutation、dispatch、GEMM、combine 的时间与重叠。
- 报告 \(M_e\) 分布、\(\rho_{\mathrm{load}}\)、padding、drop rate、远端比例和网络分位。
- 变更 EP / TP / DP 网格后恢复 checkpoint,逐 expert 核对 global ID 与 checksum。
- 在线推理同时测平均吞吐、TPOT 尾延迟、hot-expert 情况和质量差异。
系统设计应先用性能成本模型量化激活计算和通信,再按 GPU 执行模型检查小 GEMM 与 permutation 是否真正映射到硬件。token permutation、并行线性层与 checkpoint manifest 的紧凑 reference 见手撕:分布式与容错。
Reference
- DeepEP
- MoonEP
- MegaBlocks
- DeepSeek-V3
- Megatron Core MoE 指南
- Kimi K3 Technical Report
- Comet: Fine-grained Computation-communication Overlapping for Mixture-of-Experts
- FlashMoE: Fast Distributed MoE in a Single Kernel
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DeepGEMM MegaMoE public release