世界模型:从预测未来到支持决策
世界模型的价值不在于生成一段“像未来”的画面,而在于回答一个带干预的问题:
如果智能体在当前状态采取动作 \(a_t\),环境接下来怎样变化;这种预测是否足以让决策变好?
这一定义把世界模型与普通视频模型分开。视频理解模型可以说明“发生了什么”,视频生成模型可以合成“可能发生什么”;只有当模型表示了动作对未来的影响,并通过规划、策略学习或闭环控制接受检验时,它才成为决策意义上的世界模型。
从不可见状态开始
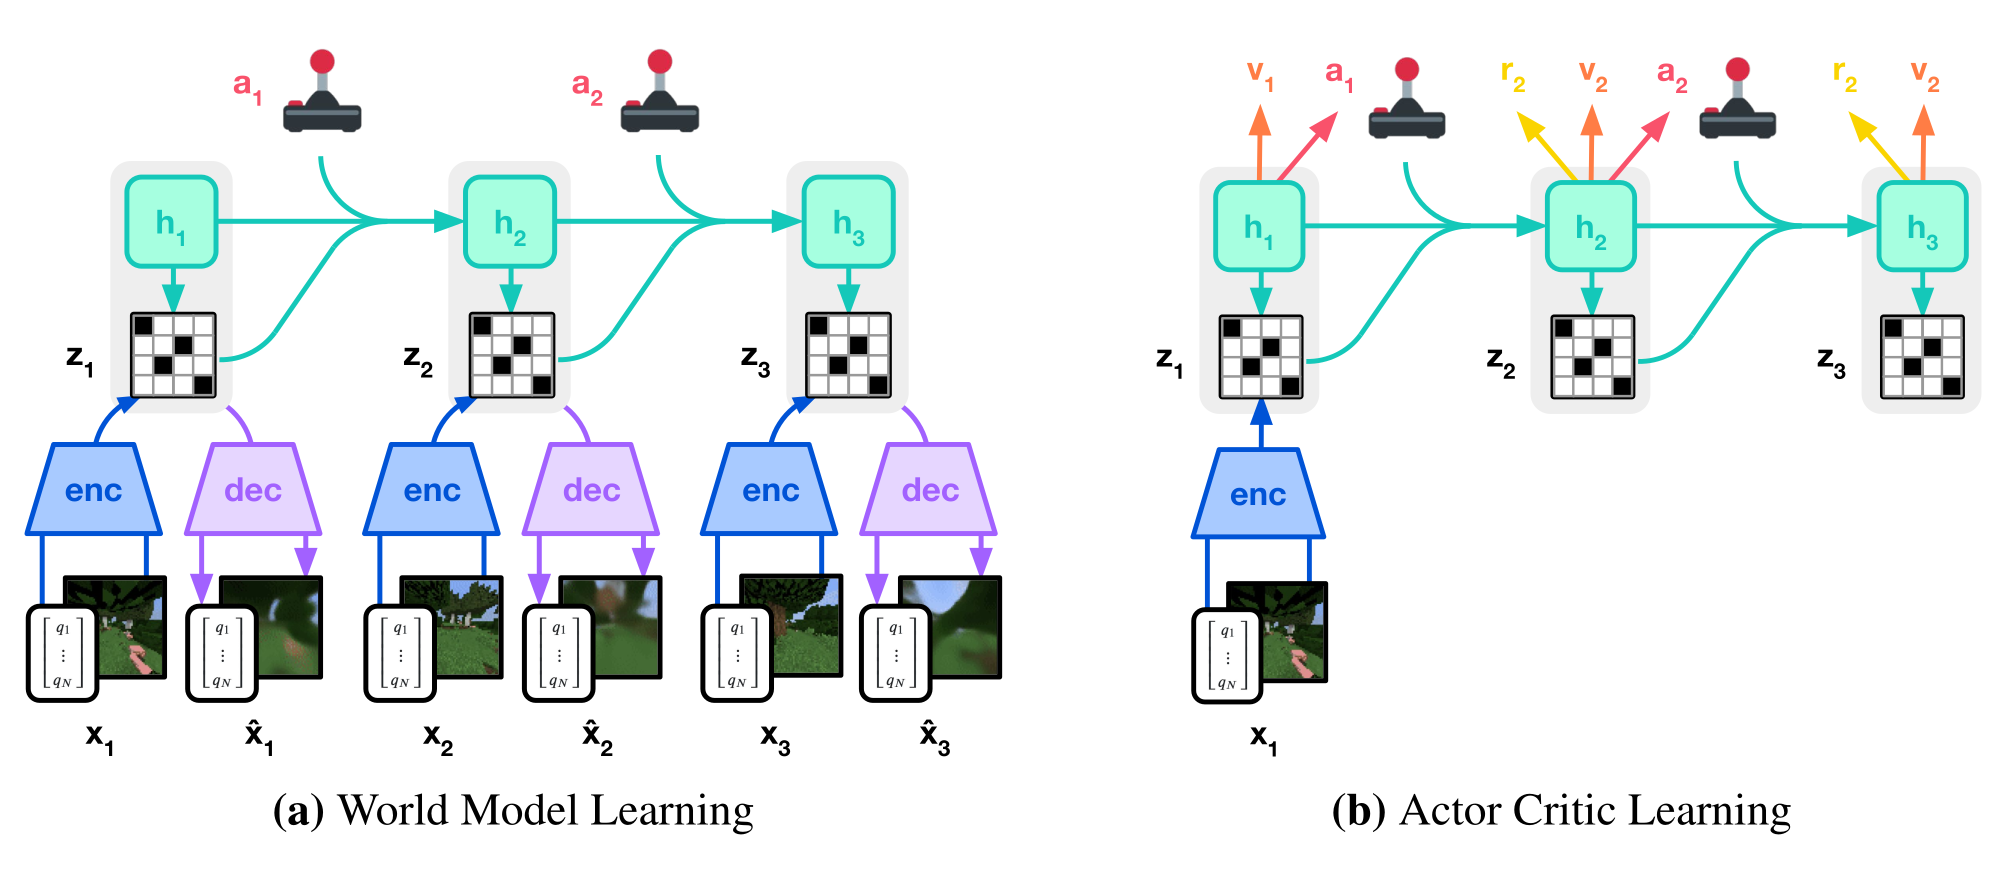
现实中的真实状态 \(s_t\) 通常不可直接观测。相机、麦克风和传感器只给出带噪、局部的观察:
模型因此先从历史中构造内部状态
再预测下一状态、观察、奖励或价值:
\(z_t\) 不必是可解码的图像。它可以是连续 latent、离散 token、对象与几何、JEPA feature,甚至只保留 reward、policy 与 value 所需的信息。选择哪一种表示,取决于模型最终服务什么决策,而不是哪一种重建看起来最清晰。
四条轴看清一个“世界模型”
同名方法经常学习完全不同的对象。阅读一项工作时,先沿四条轴定位。
| 轴 | 主要选择 | 真正要问 |
|---|---|---|
| 预测对象 | pixel、视觉 token、连续 latent、对象状态、reward/value | 丢掉的信息是否仍是任务所需 |
| 条件 | 无动作、真实动作、latent action、语言与目标 | 模型能否回答动作反事实 |
| 使用方式 | 表征预训练、imagined policy learning、MPC、MCTS、环境生成 | 预测怎样进入实际决策 |
| 时间尺度 | 单步、短 rollout、长时持续世界 | 误差怎样随 horizon 与干预累积 |
由此可以区分几条互相连接却不能混同的路线:
- 可重建动力学:预测像素或可解码 latent,便于观察模型到底想象了什么;
- 决策等价动力学:只预测 reward、policy、value 等决策充分量,MuZero 是代表;
- 预测表征:在 feature space 预测可预期结构,避开纹理噪声,V-JEPA 沿此展开;
- 交互式生成世界:同时追求视觉生成、动作响应、长时一致和在线速度,Genie 与 Cosmos 处在这条线上。
“latent”本身不是质量保证。一个 latent 可以很适合分类,却丢掉控制所需的精确位置;也可以精确重建纹理,却没有对象恒常性和可干预动力学。
一条不断改变预测目标的历史
世界模型的演进不是模型越来越大那么简单,而是研究者不断重写“为了决策,究竟需要预测什么”。
| 时间 | 问题 | 代表转折 |
|---|---|---|
| 1990 | 如何复用真实经验 | Dyna 让真实 transition 与模型生成 transition 共享学习更新 |
| 2018 | 高维视觉里怎样建模 | World Models 以 VAE + RNN + controller 拆开表征、动力学和控制 |
| 2018–2019 | 怎样在 latent 中规划或学习策略 | PlaNet 使用 RSSM 与 CEM;Dreamer 在 imagined trajectory 上训练 actor–critic |
| 2020 | 是否必须重建观察 | MuZero 只学习搜索所需的 reward、policy 与 value |
| 2024 | 是否能从无标签视频学可控变化 | Genie 联合视频 tokenizer、latent action 与动力学 |
| 2024–2026 | 是否能在语义 feature 中预测与规划 | V-JEPA 到 V-JEPA 2 把表示预测接到 action-conditioned planning |
| 2025–2026 | 能否成为通用、实时、全模态交互环境 | Genie 3、Cosmos 3 等开始汇合视频、音频、语言、动作与在线生成 |
前半段主要在可控环境中研究“学模型后怎样规划”;后半段开始吸收互联网视频与生成模型的规模,却同时带来一个新风险:视觉质量越来越容易掩盖因果、几何和控制错误。
模型怎样真正进入决策
世界模型通常通过三种接口产生价值。
在模型中搜索
给定候选动作序列 \(a_{t:t+H-1}\),模型 rollout 并计算目标:
MPC 只执行第一步或一个短前缀,获得真实观察后重新规划,以限制模型误差。可运行的 CEM 最小实现展示了这一闭环。
在模型想象中学习策略
Dreamer 一类方法在 latent rollout 中更新 actor 与 critic,再把学到的 policy 部署到真实环境。它把昂贵的在线搜索移到训练期,但 policy 可能主动利用模型漏洞。
生成可交互训练环境
交互式视频世界尝试从文本、图像或视频生成可操纵环境,供 agent 练习或评测。这里必须额外验证动作可控性、对象持续、空间结构、延迟与 reset 语义;一段连贯演示不能证明它能稳定承担训练环境。
更一般的 Dyna、search、option 与层级决策形式见模型、规划与层级决策。
预测准确不等于决策可靠
平均单步误差小,可能掩盖五类问题:
- 闭环分布漂移:模型自己的预测成为下一步输入;
- 多模态平均:多个可能未来被压成一个不存在的中间状态;
- 模型利用:planner 找到模型认为高价值、真实环境却无效的动作;
- 任务信息缺失:表示丢掉接触、速度、几何或安全边界;
- 不可校准的未知:模型在数据外仍给出尖锐预测。
若单步误差上界近似为 \(\epsilon\),非线性动力学的 rollout error 并不通常只增长为 \(H\epsilon\);状态偏差改变后续输入后,误差可能更快放大。因此应同时测:
评测应沿决策链展开
| 层级 | 评测对象 | 必须切片 |
|---|---|---|
| 表示 | state probe、位置、对象、接触、速度 | 相机、遮挡、背景、域外对象 |
| 单步预测 | latent/pixel/reward error | 动作大小、罕见事件、随机性 |
| 多步预测 | error–horizon curve、一致性 | rollout 长度、开放环与校正后 |
| 反事实 | 改变动作后未来是否正确变化 | 无动作、反向动作、不可行动作 |
| 规划 | goal distance、return、成功率 | sample budget、horizon、wall time |
| 闭环 | 成功、恢复、干预、安全成本 | 新场景、扰动、传感器与延迟 |
| 系统 | latency、吞吐、显存、reset | 同步/异步、实时预算、硬件 |
图像或视频的 FID、重建 PSNR 只能覆盖其中一小部分。对控制模型,真实环境中的 success、failure recovery 和 unsafe success 必须与开放环指标并列。
怎样读公开结果
本文及后续页面按以下证据边界叙述:
- 公开论文结果:只在论文的机器人、任务、样本数与协议内成立;
- 开放代码或权重:说明别人能够检查部分实现,不等于训练数据完整或结果已独立复现;
- 产品/研究预览:只能确认发布方公开展示和明确写出的限制;
- 未知:未披露的训练配方、数据组成、失败率与内部安全措施保持未知。
截至 2026-07-28,Genie 3 仍由发布方描述为 limited research preview;Cosmos 3 已有官方论文、代码和模型入口,但刚于 2026 年 6 月公开。二者不应仅凭演示画面被写成已经验证的通用物理模拟器。
阅读路线
- 动力学、想象与规划:Dyna、RSSM、Dreamer、MuZero、MPC 与模型偏差;
- 预测表征与生成世界:JEPA、latent action、Genie、Cosmos 与交互式视频;
- 具身智能:世界状态怎样接到真实机器人动作、数据、运行时与安全;
- 视频理解:时间证据、采样和长程记忆;
- 生成建模:VQ、diffusion、DiT 与 flow 的基础。
Reference
- Sutton, Integrated Architectures for Learning, Planning, and Reacting
- Ha and Schmidhuber, World Models
- Hafner et al., Learning Latent Dynamics for Planning from Pixels
- Hafner et al., Dream to Control
- Schrittwieser et al., Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model
- Bruce et al., Genie: Generative Interactive Environments
- Bardes et al., V-JEPA: Feature Prediction for Video Pre-Training
- Assran et al., V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
- Google DeepMind, Genie 3: A New Frontier for World Models
- NVIDIA, Cosmos 3: An Omnimodal World Model