强化学习的演进:从价值递推到语言智能体
强化学习的历史不是一条算法排行榜。它更像几条反复汇合的河流:动态规划研究已知模型下的最优控制,试错学习研究未知转移下的价值估计,policy gradient 直接调整随机策略,深度学习提供函数逼近,而人类反馈与语言模型又把“reward 从哪里来”推到中心。
1950s–1980s:先有递推,再有试错
Bellman 的动态规划把多阶段决策写成“当前收益加未来最优价值”。其核心不是某个神经网络,而是最优性原理:
动态规划假设转移和 reward 可查询。现实 agent 往往只有样本,于是问题变成:能否只从经历中逼近这条递推?
Temporal-Difference learning 把完整回报与一步 bootstrap 接起来:
TD learning 的历史意义在于:不等 episode 完成,也不需要环境模型,就能让预测随经验传播。这条思想后来进入 critic、Q-learning、GAE 与长序列 value model。
1989–2000:控制与策略梯度形成两条主线
Q-learning 把行为策略与最优性 target 分开:
它适合能枚举动作的离散控制,却在巨大组合动作空间中遇到困难。完整语言 response 虽由离散 token 组成,但无法枚举所有序列再取 \(\max\)。
另一条路线直接参数化策略。REINFORCE 使用采样回报更新动作概率,Policy Gradient Theorem 则把函数逼近、状态访问分布与 advantage 放进统一表达:
语言模型后训练主要继承这条 policy-based 路线,因为自回归策略能直接给已采样 token 计算 log-probability。
2000s–2015:函数逼近既带来规模,也带来失稳
当 value 或 policy 由神经网络表示,表格方法的局部更新会变成共享参数更新。一个样本可能改变大量状态的预测;再叠加 bootstrap 和 off-policy 数据,就形成致命三元组。
DQN 用 experience replay、target network 和卷积表征把 value-based deep RL 推到 Atari。它说明大模型可以从高维观察中学到控制表征,也提醒人们:稳定性来自一组相互配合的约束,不是“把 Q 表换成神经网络”。
同一时期,TRPO 从策略性能差异和 KL 约束出发限制更新幅度;GAE 用指数加权 TD residual 在偏差与方差间折中。这两项工作直接铺垫了后来的 PPO 与大模型 actor–critic。
2016–2018:稳定策略优化与分布式采样
PPO 用一阶优化和 clipped surrogate 近似 trust-region 思想。它易于扩展、可以对同一 rollout 做多个 epoch,因此成为许多 RLHF 系统的起点;但 clipping 不等于严格 KL 约束,仍需监控 ratio、KL 与 value drift。
IMPALA 把 actor 与 learner 解耦,并用 V-trace 修正滞后的 behavior policy。这里出现了今天大模型异步 RL 仍在处理的核心矛盾:
2016–2021:自博弈、最大熵、规划与离线数据
策略优化并没有独占深度 RL 的发展。AlphaGo Zero 把神经网络、自博弈与 Monte Carlo Tree Search 组成闭环:policy/value network 为搜索提供先验,搜索结果再成为训练目标。随后 MuZero 进一步只学习规划所需的 latent dynamics,而不要求重建完整 observation。它们沿着模型、规划与层级决策回答“何时应该在参数更新之外显式搜索未来”。
连续控制中的 Soft Actor-Critic 把 entropy 写进目标,在探索与回报之间建立可优化的温度;对应的最大熵视角见探索与最大熵。与此同时,现实数据常无法持续在线采集,Conservative Q-Learning 等 offline RL 工作开始直接处理 dataset support 外的过估计,连接到模仿学习与 Offline RL。
这几条支流后来都回到大模型系统:搜索与 verifier 组成测试时计算,entropy 影响 reasoning diversity,offline preference 则在不运行在线环境时改进策略。它们说明 RL 历史不是 PPO 单线延伸。
2017–2022:reward 从环境函数变成可学习对象
Deep RL from Human Preferences 把轨迹片段比较训练成 reward model,再由 RL 优化策略。它将两个问题分开:
- 怎样从反馈估计目标;
- 怎样在估计目标下改进策略。
随后,语言模型偏好微调、摘要的人类反馈训练与 InstructGPT 逐步形成 SFT、preference data、reward model、PPO 与 KL anchor 的语言模型闭环。
这条路线的关键进步是让开放式行为拥有可优化反馈;新的风险则是 reward model 只在采样分布附近可信,策略会主动寻找它的漏洞。
2023–2024:离线偏好与可验证 reward 分流
DPO 利用 KL 正则化最优策略的闭式关系,把成对偏好直接变成 policy/reference log-ratio 的分类目标。它减少了在线采样、critic 与显式 reward model,却没有消除偏好数据覆盖、reference 选择和 reward 假设。
另一条路线在数学、代码等任务上使用程序可判定的 reward。DeepSeekMath 提出 GRPO,以同题多条 rollout 的组统计替代 learned critic;RLOO 的系统研究则重新强调简单 REINFORCE baseline 在语言 RL 中的竞争力。
两条路线分别回答不同问题:
- 离线偏好:已有比较数据时,怎样改变回答排序;
- 在线 RLVR:能可靠判定结果时,怎样探索训练分布之外的新轨迹。
2025–2026:推理、长轨迹与异步系统重新汇合
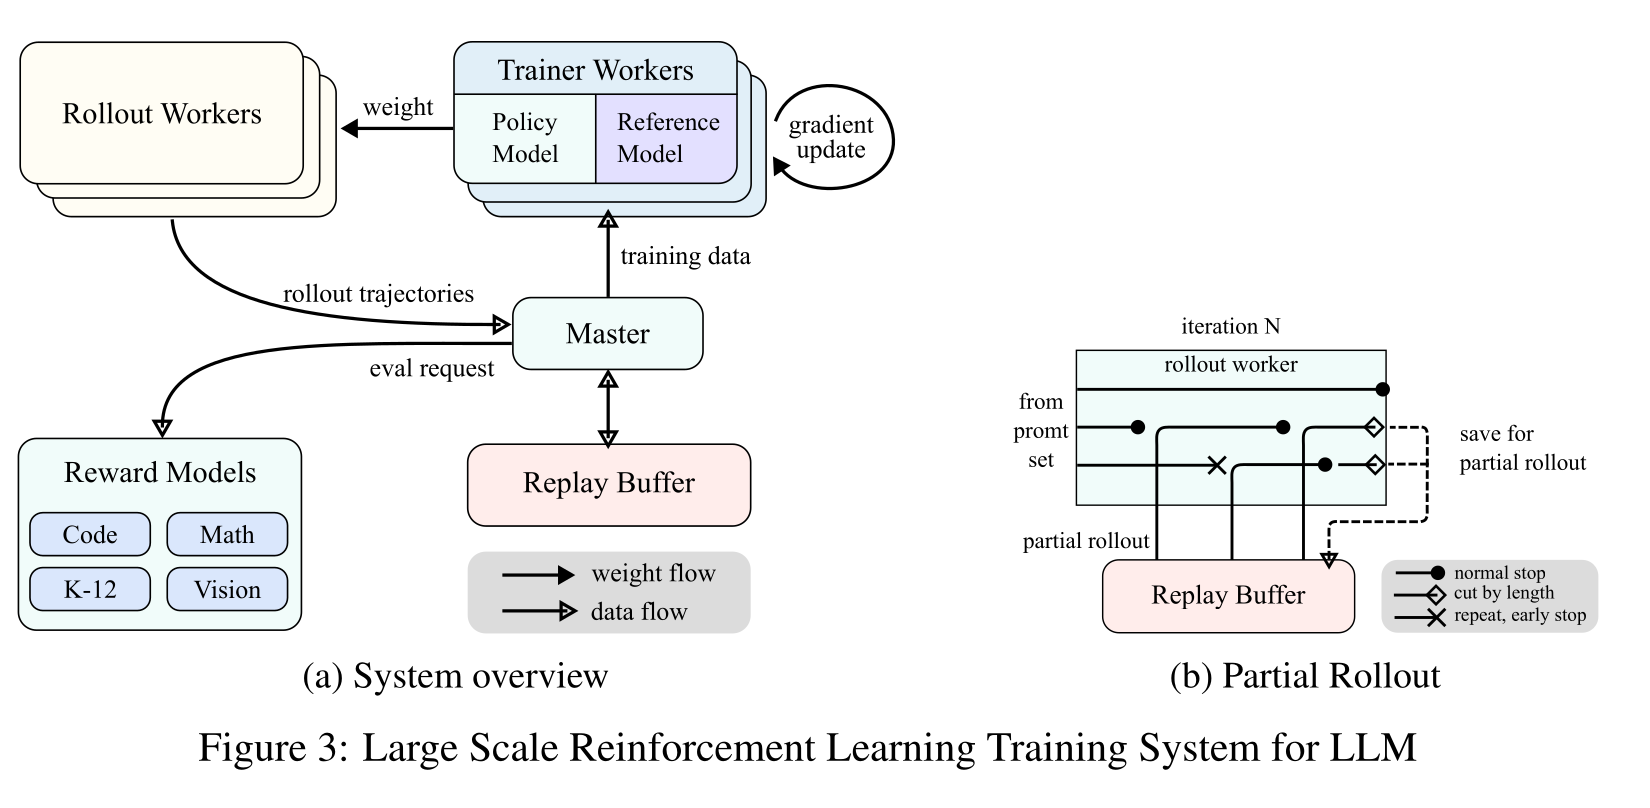
DeepSeek-R1 把可验证 reward、group-relative optimization、冷启动数据和蒸馏组织成推理后训练路线。随后大量工作围绕 clipping、长度归一化、无信号组、process reward 和异步 rollout 调整具体 estimator。读这些方法时,应把“目标函数变化”和“采样预算、过滤、系统吞吐变化”分开。
Baseline 与分母
Dr. GRPO 把 group std 与 response-length denominator 带来的权重显式化;DAPO 把 Clip-Higher、mixed-group sampling、global token loss 与 overlong handling 组合成开放配方;VAPO 则重新引入并预热 critic,用 decoupled、length-adaptive GAE 处理长短混合。它们不是一条“新算法依次取代旧算法”的榜单,而是沿 baseline、长度、探索与采样成本分叉。
Update geometry 与 engine mismatch
随后 CISPO、GSPO 与 SAPO 从 detached weight、sequence ratio 与 smooth gate 三个方向修改更新几何;TIS、IcePop 与 R3 又把训练引擎与 rollout 引擎的分布差搬到算法层处理。完整因果链见推理策略优化谱系。
Long-horizon 与异步系统
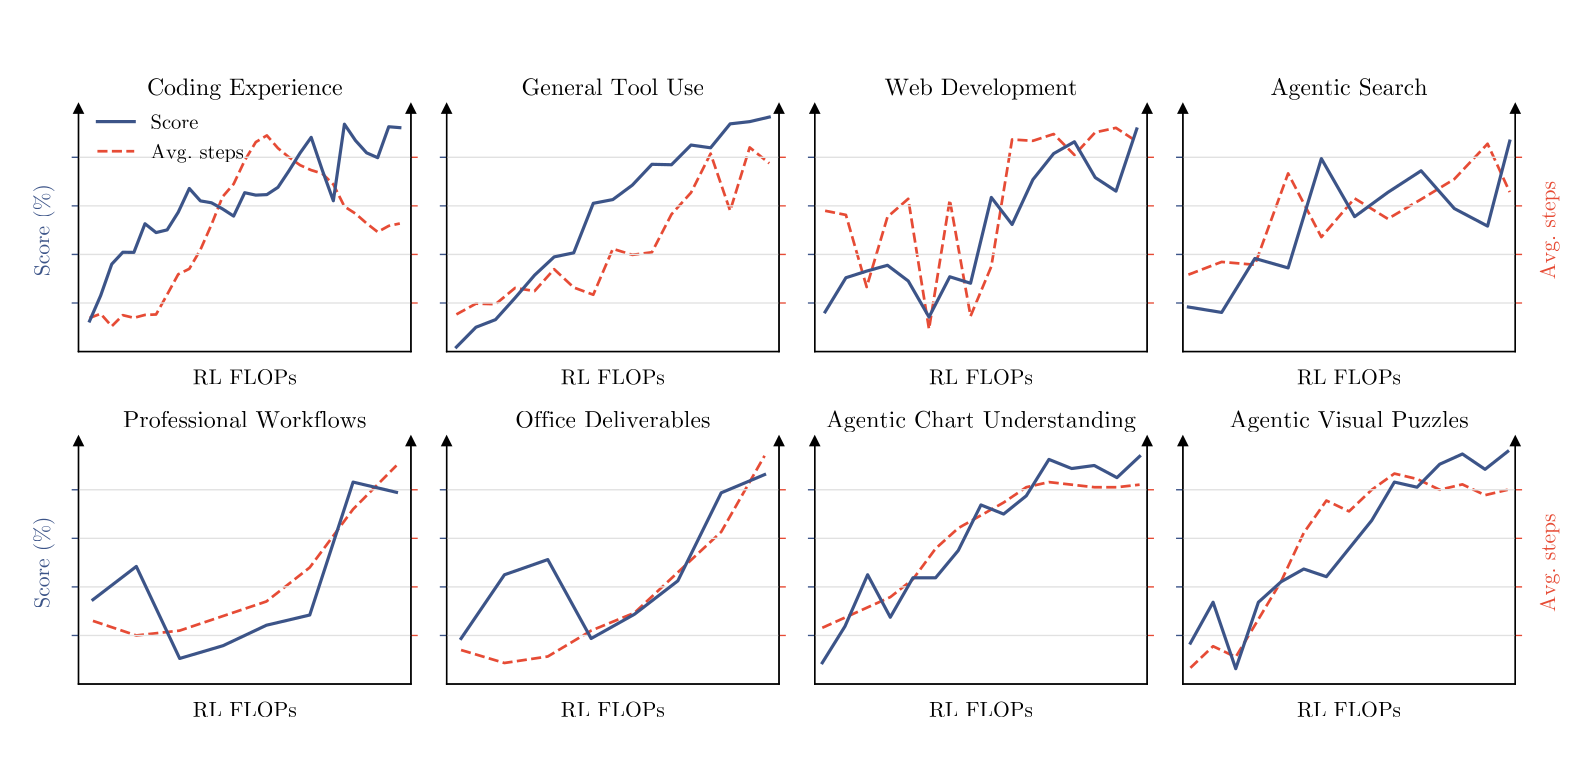
多轮 agent 又让经典问题以更极端的形式返回:
- observation 不是 policy action;
- episode 可能跨数百轮,reward 极度延迟;
- 工具与环境会失败或漂移;
- 同一轨迹生成期间 learner 已更新多次;
- 上下文压缩改变了后续可见状态。
SAO 与 CompactionRL 分别研究异步 group barrier 与上下文压缩后的信用接口。它们说明“新的 LLM RL”并没有脱离经典 RL;相反,policy gradient、critic、importance sampling 和 partial observability 在更大的系统里重新变得不可回避。
一条不变的审题线
无论论文使用 PPO、DPO、GRPO 还是新的缩写,都先问:
- 状态和动作单位是什么;
- 数据由哪个策略、以什么采样分布产生;
- reward 是环境事实、偏好代理还是 learned verifier;
- baseline/critic 在估计什么;
- 分母按 token、response、prompt 还是 episode;
- 更新怎样限制分布漂移;
- 结果是否在独立目标上验证。
这些问题分别由序贯决策、策略梯度、Off-policy 校正、语言模型策略与实验诊断继续展开。
Reference
- Bellman, Dynamic Programming
- Sutton and Barto, Reinforcement Learning: An Introduction, Second Edition
- Sutton, Learning to Predict by the Methods of Temporal Differences
- Watkins and Dayan, Q-learning
- Williams, Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning
- Sutton et al., Policy Gradient Methods for Reinforcement Learning with Function Approximation
- Mnih et al., Human-level Control through Deep Reinforcement Learning
- Schulman et al., Trust Region Policy Optimization
- Schulman et al., High-Dimensional Continuous Control Using Generalized Advantage Estimation
- Schulman et al., Proximal Policy Optimization Algorithms
- Espeholt et al., IMPALA: Scalable Distributed Deep-RL with Importance Weighted Actor-Learner Architectures
- Silver et al., Mastering the Game of Go without Human Knowledge
- Haarnoja et al., Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor
- Schrittwieser et al., Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model
- Kumar et al., Conservative Q-Learning for Offline Reinforcement Learning
- Christiano et al., Deep Reinforcement Learning from Human Preferences
- Ziegler et al., Fine-Tuning Language Models from Human Preferences
- Stiennon et al., Learning to Summarize with Human Feedback
- Ouyang et al., Training Language Models to Follow Instructions with Human Feedback
- Rafailov et al., Direct Preference Optimization
- Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- Ahmadian et al., Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs
- Guo et al., DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Liu et al., Understanding R1-Zero-Like Training: A Critical Perspective
- Yu et al., DAPO: An Open-Source LLM Reinforcement Learning System at Scale
- Yue et al., VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks
- MiniMax et al., MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention
- Zheng et al., Group Sequence Policy Optimization
- Gao et al., Soft Adaptive Policy Optimization
- On the Rollout-Training Mismatch in Large-Scale Reinforcement Learning
- Ling Team et al., Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model
- Ma et al., Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers
- Hou et al., Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning
- Li et al., CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents