视频与世界模型
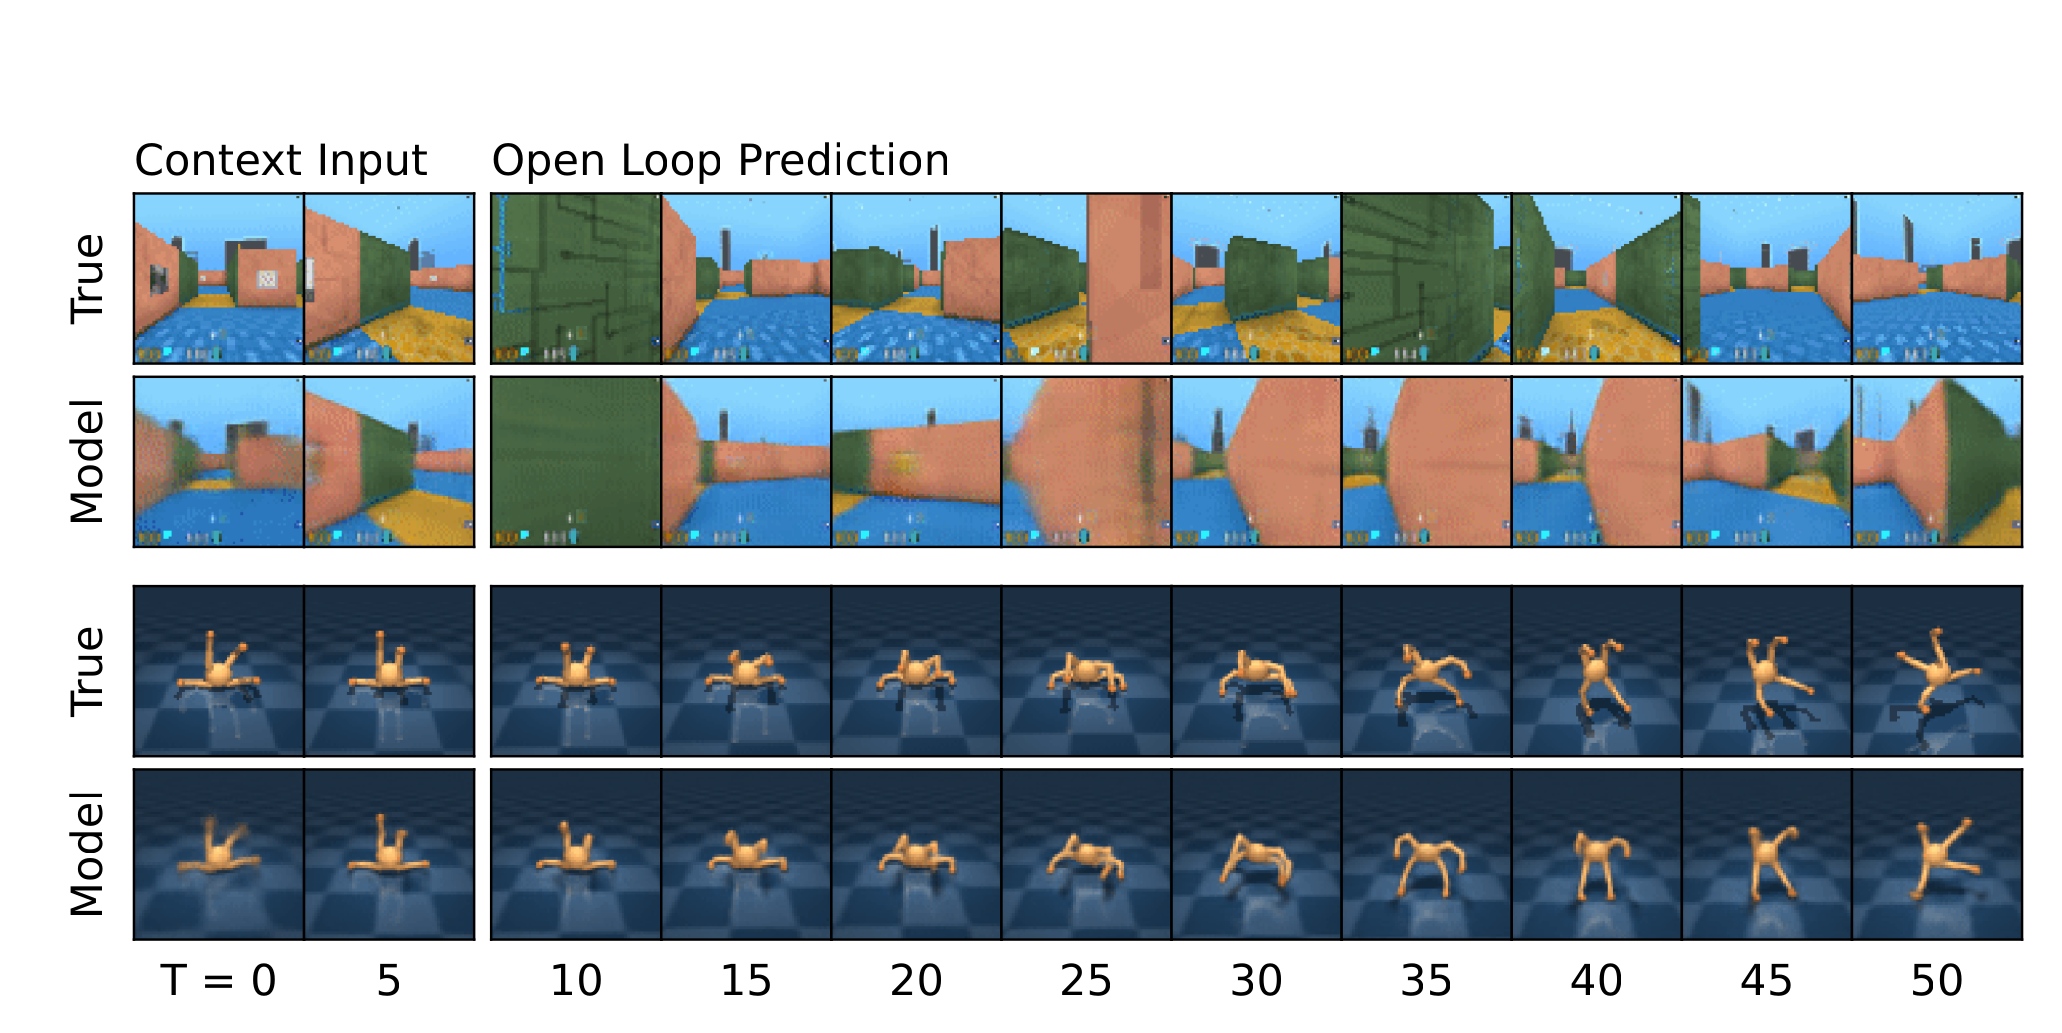
视频模型不仅处理更多图像,还要表示运动、持续身份、事件顺序和时间因果。世界模型进一步尝试预测环境怎样随动作变化;视觉上逼真的视频不自动等于可用于规划的动力学模型。
时空 token
对 \(T\times H\times W\) 视频,以 tubelet
切分,token 数为
增加时长、帧率或分辨率都会放大 token budget。压缩策略包括 temporal pooling、tubelet、关键帧、resampler、分层摘要和检索后精读。
均匀采样简单但会漏掉短事件;问题驱动采样可能在尚未理解视频时选错时间段。长视频系统常先低成本粗扫,再对候选片段提高帧率与分辨率。
最小语义实现
tubelet_patchify 把 [B,C,T,H,W] 视频按 (P_t,P_h,P_w) 展开为时空 token,并返回三维 grid;逆函数用同一 layout 恢复视频。往返断言能同时发现时间/通道轴互换和错误的 flatten 顺序。
import torch

def tubelet_patchify(video, tubelet):
    batch, channels, time, height, width = video.shape
    pt, ph, pw = tubelet
    assert time % pt == height % ph == width % pw == 0
    grid = time // pt, height // ph, width // pw
    nt, nh, nw = grid
    x = video.view(batch, channels, nt, pt, nh, ph, nw, pw)
    patches = x.permute(0, 2, 4, 6, 1, 3, 5, 7).reshape(batch, nt * nh * nw, -1)
    return patches, grid

def tubelet_unpatchify(patches, channels, grid, tubelet):
    batch, (nt, nh, nw), (pt, ph, pw) = patches.size(0), grid, tubelet
    x = patches.view(batch, nt, nh, nw, channels, pt, ph, pw)
    return x.permute(0, 4, 1, 5, 2, 6, 3, 7).reshape(
        batch, channels, nt * pt, nh * ph, nw * pw
    )

video = torch.arange(2 * 3 * 4 * 8 * 6).view(2, 3, 4, 8, 6)
tubelets, grid = tubelet_patchify(video, (2, 4, 3))
assert tubelets.shape == (2, 8, 72)
torch.testing.assert_close(tubelet_unpatchify(tubelets, 3, grid, (2, 4, 3)), video)
真实视频管线还要保存 frame timestamp、可变帧率、crop/tile 坐标和 padding mask;tubelet 只减少 token 数,不会恢复被稀疏采样漏掉的短事件。可运行的 layout 实验见多模态原语:Video tubelet。
时空位置
每个 token 至少有
坐标。实现可以使用:
- flatten 后的一维位置;
- 时间与空间分解 embedding;
- 多维 RoPE;
- 相对时间偏置与二维空间偏置。
需要同时保存 frame timestamp,而不只保存 frame index。不同帧率、可变帧间隔、剪辑与多段视频会使 index 不再等于真实时间。
Attention mask
视频理解 encoder 可以在整段输入上双向 attention;自回归未来预测要求时间因果:
同一帧内可允许双向空间 attention。若训练目标声称预测未来,必须确保任何 normalization、temporal convolution、resampler 或 cross-attention 都没有读取未来帧。
视频理解
视频问答至少分解为:
- 瞬时对象与属性;
- 短事件定位;
- 动作顺序与持续时间;
- 跨镜头实体与指代;
- 音视频同步;
- 长视频证据检索;
- 事件因果与反事实。
全局 caption 对细粒度时间定位监督很弱。若任务需要回答“何时发生”,训练标签应包含时间区间或稠密事件描述。
视频生成
自回归 latent:
Diffusion/flow 则在时空 latent 上联合生成。主要设计轴包括:
- 2D 空间 backbone + 时间模块;
- 3D attention/convolution;
- 分辨率与帧率级联;
- 整段生成或滑窗扩展;
- 文本、首帧、关键帧与动作条件。
VideoPoet 探索统一 token 化的多模态视频生成,Lumiere 使用 space-time diffusion,CogVideoX 公开了面向文本到视频的 diffusion Transformer 路线。
长时一致性
逐帧局部质量不能保证:
- 人物和物体身份持续;
- 数量与拓扑保持;
- 遮挡后重新出现一致;
- 镜头切换符合叙事;
- 动作结果延续到后续状态;
- 音频、嘴形和事件同步。
评测应按时间跨度切片,并检查错误是否随 rollout length 累积。
世界模型
一般世界模型学习
其中 \(z_t\) 是观测 latent,\(a_t\) 是动作。若没有动作条件,模型学习的主要是观测序列规律,不能识别智能体行为对未来的因果影响。
Genie 研究从互联网视频学习可控制环境;它说明潜在动作和交互世界生成的一条路线,但从视频推断 latent action 仍受可识别性约束。
JEPA 表示预测
V-JEPA 不直接重建像素,而在表示空间预测被遮挡的时空区域:
表示预测可忽略不可预测像素细节并聚焦语义结构,但 loss 小不自动意味着表示足以进行控制、精确位置恢复或长期规划。
“世界模拟器”声明
Sora 技术说明展示了时空 patch、规模扩展和视频生成现象,同时明确没有披露完整模型与实现细节。此类材料可作为公开观察,不宜承担以下结论:
- 模型已学得真实物理定律;
- 视觉逼真等于可用于闭环控制;
- 未公开架构可按展示反向确定;
- 单次成功样例代表稳定因果模拟。
世界模型能力需通过动作干预、反事实、长 rollout 和状态可恢复性验证。
Shape 与实现契约
原始视频:
实现需要固定:
- 时间轴与通道轴 layout;
- frame rate、timestamp 与可变间隔;
- resize、crop 和 tubelet 参数;
- position IDs 与 segment boundary;
- temporal mask 是否严格因果;
- 音频和字幕同步;
- sliding-window 生成的重叠与状态;
- 动作发生在观测前还是观测后。
失效模式
- 时间混叠:低帧率漏掉快速事件或反转顺序。
- 未来泄漏:训练中的双向路径破坏预测定义。
- 身份漂移:对象外观、数量和属性随时间改变。
- 运动—外观纠缠:模型靠背景纹理猜动作。
- 镜头边界错误:把剪辑误当物体瞬移或动力学。
- Rollout 累积:微小状态误差不断放大。
- 动作不可识别:相同观测变化对应多种潜在行为。
- 逼真度替代正确性:感知质量掩盖因果与物理错误。
验证矩阵
| 维度 | 测试 |
|---|---|
| 采样 | 不同帧率、短事件、可变时间间隔 |
| 定位 | 时间区间、顺序、跨镜头实体 |
| 因果 | 未来泄漏探针、动作干预、反事实 |
| 一致 | 身份、数量、遮挡恢复、长时属性 |
| 生成 | 文本遵循、运动、镜头、音视频同步 |
| Rollout | 误差随 horizon 的曲线 |
| 系统 | 原始时长、token、prefill、显存和生成成本 |
| 开环/闭环 | 离线预测与环境实际执行分别评测 |
动作输出和闭环验证见具身智能与动作,长输入利用见长上下文,时空 patch 与 mask 练习见多模态手撕实现。
继续深入
视频与世界模型在这里保留稳定交汇入口,但 canonical 边界已经拆开:
- 视频理解与长程记忆讨论采样、事件定位和证据;
- 视频生成讨论时空 latent、causal rollout 和音画同步;
- 世界模型总览区分视频预测、latent dynamics、JEPA 和交互模拟器;
- 表示预测与生成式世界比较动作条件、latent action 与闭环可用性。