Latent Diffusion、DiT 与 Flow:从压缩空间到连续生成
现代图像生成的主干变化,看起来像一连串替换:
更准确地说,它同时回答了三类不同问题:
- 状态在哪里:像素、重建 latent,还是预训练语义 representation;
- 网络怎样表示向量场:卷积 U-Net、DiT 或多流 Transformer;
- 怎样从先验走到数据:随机反向扩散、概率流 ODE、flow matching 或少步一致性映射。
Backbone、训练路径与 sampler 属于三层契约。把它们都称为“diffusion Transformer”会掩盖真正的可替换边界。
为什么先离开像素空间
一张 \(H\times W\) RGB 图像包含大量人眼不敏感的局部冗余。若先用 autoencoder
把它压到
那么主要生成计算从 \(HW\) 个像素位置转移到 \(H'W'=HW/f^2\) 个 latent 位置。Latent Diffusion 的关键不只是“用 VAE 省显存”,而是寻找一种 perceptual compression:丢掉难以察觉的像素级冗余,同时保留构图与语义。
这带来明确上限:
二者不能从最终样图中直接分离。评测必须先做真实图像的 autoencoder-only reconstruction,再评 prior;否则可能把 decoder 的文字损失误判为 denoiser 的问题。
latent_scale 同样是概率契约。扩散或 flow 看到的是 \(sE(x)\) 的经验分布;换 encoder、漏乘 \(s\) 或混用 posterior mean/sample,都会改变噪声与数据的相对尺度。
从 U-Net 到 DiT:归纳偏置换成规模化接口
U-Net 以多尺度卷积和 skip connection 高效处理局部纹理。Transformer 则把 latent 切成 patch:
其中
DiT 系统比较 Transformer 去噪 backbone,并发现增加模型计算量与生成质量之间存在清晰趋势。这里的 DiT 仍然是双向处理当前 noisy latent 的回归器,不是按 token 自回归生成的语言模型。
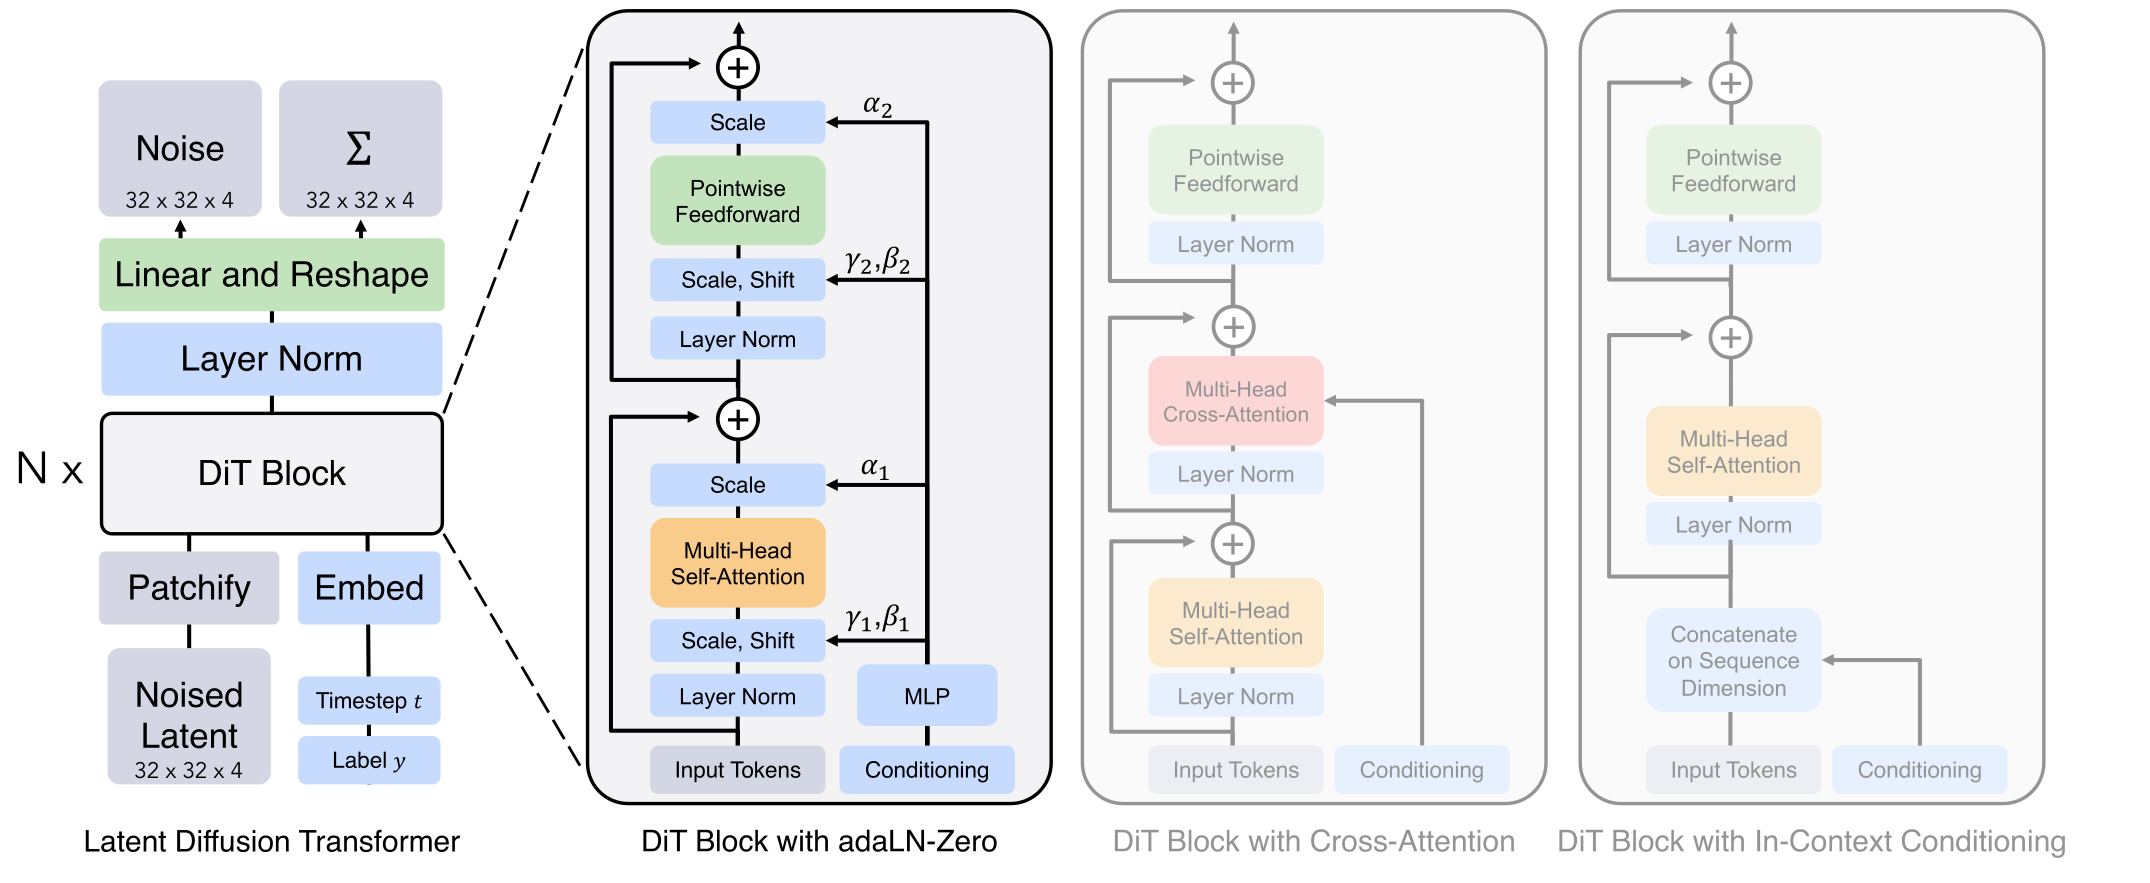
Patch size \(P\) 决定计算与细节:
- \(P\) 大,\(N\) 小,attention 便宜,但细粒度空间交互被推给 patch projection/decoder;
- \(P\) 小,空间分辨率高,attention 成本近似 \(O(N^2d)\);
- autoencoder 下采样率 \(f\) 与 DiT patch \(P\) 共同决定一个 token 覆盖的原图区域 \(fP\times fP\)。
因此“相同输入分辨率”不意味着相同 token budget。
时间与条件怎样进入 block
DiT 的一个常见接口是 adaptive layer normalization。用时间/条件 embedding \(c\) 产生 scale、shift 与 residual gate:
一个 block 可写为
AdaLN-Zero 把最后的 modulation/gate 初始化为零,使初始网络接近恒等映射,深层训练更稳定。zero initialization 指特定输出投影或 gate,不是把整个 block 权重清零。
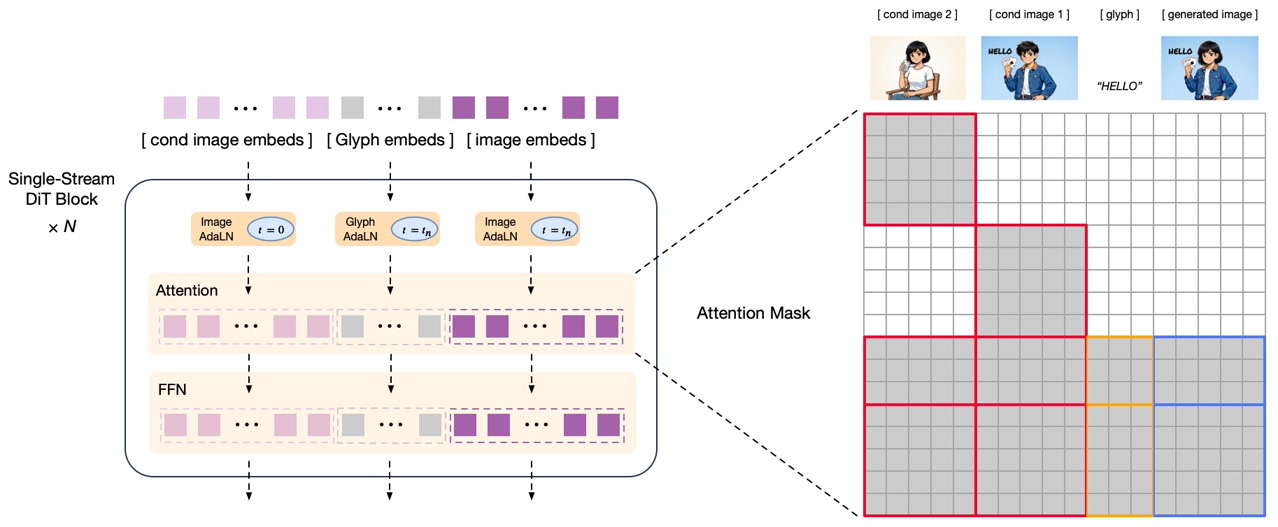
文本还可通过 cross-attention 注入。PixArt-\(\alpha\)展示训练分解、强文本 encoder 与高质量数据的重要性;Stable Diffusion 3 的 MMDiT 让文本与图像各保留 stream-specific 参数,再在 joint attention 中交换信息。不同条件接口不能只凭“是否 joint”排序:还要看文本 token 长度、位置编码、条件 dropout 与训练数据。

Flow matching:直接学习运输速度
接下来暂用 \(z_0\) 表示噪声端、\(z_1\) 表示数据端,避免与 diffusion 中常把 \(x_0\) 写成干净样本的记号冲突。选择条件概率路径
其条件速度为
Flow Matching 训练网络回归:
在平方损失下,最优 marginal vector field 是给定 \(z_t\) 后条件速度的期望。推理再解 ODE:
最简单的线性路径
有
目标看起来比 diffusion 简洁,并不意味着 learned marginal field 是常数:同一个 \(z_t\) 可能由许多 \((z_0,z_1)\) pair 到达,网络只能依据当前位置估计条件平均速度。
Rectified flow 在“拉直”什么
Rectified Flow 从任意 coupling 的直线插值学习 flow,并可通过 reflow:用当前模型把 base sample 映到 generated sample,再将这些配对用于下一轮训练。目标是让 individual trajectories 更直,使少步 Euler 的截断误差下降。
要区分三个“直”:
- 条件插值 \((z_0,z_1)\) 本身是直线;
- marginal velocity field 的积分轨迹是否直;
- 数值 solver 在有限步下是否准确。
第一条不自动推出后两条。Coupling、模型容量、条件 guidance 与训练误差都会让轨迹弯曲。
SiT 用 stochastic interpolants 统一讨论 diffusion 与 flow 类目标。更一般地,设
不同 \(\alpha,\sigma\)、target 和 weighting 可以表达 denoising、score 或 velocity learning。判断两个方法是否“等价”,至少要同时比较:
- 端点分布;
- 时间 parameterization;
- target 的线性变换;
- loss weighting 与 timestep sampling;
- 推理 ODE/SDE 与网格。
只看到两者都预测 velocity 并不足以判等。
Flow 与 normalizing flow 不是同一件事
Normalizing flow 用可逆映射 \(F_\theta\) 和 Jacobian determinant 计算精确 likelihood:
Continuous normalizing flow 通过 divergence 积分 density change。Flow matching 主要是一种无须在训练时积分 ODE 的向量场回归方法;它可以定义 CNF,但训练目标本身不等于已经计算了 likelihood。是否能可靠求 likelihood,仍取决于 ODE 可逆性、divergence estimator 与数值精度。
Sampler:Euler、Heun 与 NFE
给定时间网格 \(0=t_0<\cdots<t_K=1\),Euler 为
Heun 先预测终点,再平均两端斜率:
Heun 每步通常需要两次 network function evaluation(NFE)。比较“20-step Heun”与“20-step Euler”若不报告 NFE,就把两倍网络调用隐藏了。
下面约定 flow 从 \(t=0\) 的 base 积分到 \(t=1\) 的 data,模型时间输入为 [batch]。网格必须严格递增;若模型采用 data-to-noise 方向,应在 scheduler 边界显式变换。
import torch
@torch.no_grad()
def integrate_flow(x, velocity, time_grid, method="heun"):
    if x.ndim < 2 or time_grid.ndim != 1 or time_grid.numel() < 2:
        raise ValueError("x needs batch; time_grid needs at least two points")
    if not torch.all(time_grid[1:] > time_grid[:-1]):
        raise ValueError("time_grid must increase from base to data")
    if method not in {"euler", "heun"}:
        raise ValueError("method must be euler or heun")
    for t0, t1 in zip(time_grid[:-1], time_grid[1:]):
        dt = t1 - t0
        batch_t0 = x.new_full((x.size(0),), float(t0))
        k1 = velocity(x, batch_t0)
        if k1.shape != x.shape:
            raise ValueError("velocity must preserve sample shape")
        if method == "euler":
            x = x + dt * k1
        else:
            proposal = x + dt * k1
            batch_t1 = x.new_full((x.size(0),), float(t1))
            k2 = velocity(proposal, batch_t1)
            x = x + dt * (k1 + k2) / 2
    return x
grid = torch.linspace(0, 1, 5)
start = torch.zeros(2, 3)
constant = integrate_flow(start, lambda x, t: torch.ones_like(x), grid)
torch.testing.assert_close(constant, torch.ones_like(start))
def time_velocity(x, t):
    return 2 * t.reshape(-1, *([1] * (x.ndim - 1))) * torch.ones_like(x)
quadratic = integrate_flow(start, time_velocity, grid, method="heun")
torch.testing.assert_close(quadratic, torch.ones_like(start))
assert not quadratic.requires_grad
真实 sampler 还需要 precision policy、CFG 双分支、adaptive/nonuniform grid、decoder 与随机 seed。若使用 adaptive solver,不同 prompt 的 NFE 可能不同,吞吐评测必须报告分布而非单个平均值。
一步与少步:把轨迹压进更短映射
Progressive Distillation 让 student 用一步模仿 teacher 的两步,并反复把采样步数减半。Consistency Models 要求同一 probability-flow trajectory 上任意点映射到一致终点:
Latent Consistency Models 把一致性学习带入 latent text-to-image;Adversarial Diffusion Distillation 引入 adversarial objective 改善少步感知质量。少步方法应分别报告:
- 是否依赖一个更昂贵 teacher;
- 一步、两步、四步质量;
- 蒸馏数据是否由 teacher 合成;
- 新 prompt、强 CFG 与领域外分布的退化;
- 训练总成本,而非只报推理延迟。
MeanFlow 学习时间区间上的平均速度而非只估计瞬时速度,目标是让大步更新更直接。截至 2026-07-28,这类快速演进结果应按作者报告、公开代码版本与披露评测理解;“单步”也要确认是否把 text encoder、latent 初始化和 decoder 排除在计时之外。
表示空间还在变化
Diffusion Transformers with Representation Autoencoders 把传统重建 VAE encoder 替换为预训练 representation encoder,再训练 decoder。语义更强、通道更宽的 latent 可能降低 prior 的建模难度,也改变 DiT 的输入统计、patch projection 和 noise schedule。Scaling Diffusion Transformers with Representation Autoencoders 继续探索这一方向;相关规模与效果截至 2026-07-28 仍应以作者披露的具体版本为边界。
这使“压得越小越好”不再成立。真正目标是端到端 Pareto:
实现契约
| 层 | 必须固定 |
|---|---|
| Representation | encoder/decoder id、latent scale、posterior mean/sample、layout |
| Patchify | \(P\)、padding、flatten 顺序、位置编码、动态分辨率策略 |
| DiT | condition interface、AdaLN gate、text encoder、attention mask |
| Path | base/data 端点、\(\alpha(t),\beta(t)\)、coupling、time sampling |
| Target | noise、data、instant velocity、average velocity、weighting |
| Guidance | condition dropout、空条件、scale/rescale、negative prompt |
| Solver | 方向、网格、Euler/Heun/高阶、NFE、stochasticity |
| Decode | latent inverse scale、VAE precision、tiling、输出值域 |
一次端到端 golden test 应保存:固定 prompt、固定 base noise、每个 solver checkpoint 的 latent checksum、最终 decoder 输出。只保存最终 PNG 会让错误定位过晚。
失效模式与评测
Representation bottleneck
先比较 \(D(E(x))\) 与 \(x\)。若 reconstruction 已失败,调 DiT 或 solver 只能让错误更自然,不能恢复证据。
Patch aliasing
大 patch、强空间压缩会首先损伤小字、细线、手指和重复计数。按对象尺度与空间频率切片,不要只看总体 FID。
Flow 方向与时间单位
训练把 \(t=0\) 定义为 data,推理 helper 却按 base-to-data 积分,是最常见的灾难性静默错误。用常向量场与已知边界做单元测试。
Guidance 使路径变弯
模型在无 guidance 或训练 guidance 分布上学到的平滑轨迹,可能在高 CFG 下显著弯曲。少步 sampler 的损失通常比多步更明显,因此步数与 guidance 应做二维网格。
少步的 best-of-\(N\) 幻觉
若系统一次生成多张再重排,单张延迟与总计算都应报告。挑选后样例不能代表 unconditional coverage。
| 维度 | 建议测量 |
|---|---|
| 质量与覆盖 | FID/KID、precision/recall、人工成对比较 |
| 条件遵循 | 组合 prompt、文字、计数、空间与属性绑定 |
| 表示上限 | reconstruction LPIPS/FID、OCR、identity |
| 数值误差 | toy ODE、同 NFE solver 比较、步长收敛 |
| 规模规律 | 参数、训练 FLOPs、token 数、数据量分别控制 |
| 系统 | NFE、text encoder/decoder 在内的端到端延迟、吞吐、显存 |
Diffusion 与 score 的推导见 Diffusion 与 Score;latent 本身的量化与重建边界见 Autoencoder 与视觉 Tokenizer;可控条件、编辑与组合评测见可控生成、编辑与评测。
CFG、flow 积分与退化步长测试见多模态手撕实现。
Reference
- Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models
- Salimans and Ho, Progressive Distillation for Fast Sampling of Diffusion Models
- Liu et al., Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
- Lipman et al., Flow Matching for Generative Modeling
- Peebles and Xie, Scalable Diffusion Models with Transformers
- Song et al., Consistency Models
- Chen et al., PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis
- Luo et al., Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference
- Sauer et al., Adversarial Diffusion Distillation
- Ma et al., SiT: Exploring Flow and Diffusion-based Generative Models with Scalable Interpolant Transformers
- Esser et al., Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- Geng et al., Mean Flows for One-step Generative Modeling
- Zheng et al., Diffusion Transformers with Representation Autoencoders
- Zheng et al., Scaling Diffusion Transformers with Representation Autoencoders