GLM-5 架构:把容量、状态与长上下文成本分开
GLM-5 的架构价值不只在于把模型扩到 744B 参数。更值得追踪的是,它把四种原本容易混在一起的成本分别处理:MoE 承担容量扩展,MLA 压缩逐 token 的注意力状态,shared-parameter MTP 把一次训练信号延伸到多个未来 token,DSA 再把长上下文中的核心注意力从全量扫描改为候选检索。与此同时,Muon Split、MLA-256 与高效注意力消融说明:训练优化器、参数布局和推理内核并不是模型结构之外的附属问题,而是同一个联合设计问题。
本文聚焦 GLM-5 技术报告 中可以精确核对的架构与消融结果。模型的训练、后训练与能力评测在 GLM-5 全景页 中展开;稀疏索引的跨层复用则见 IndexCache。涉及通用机制时,本文尽量链接到 MoE、注意力变体、优化器家族 与 推测解码,避免把一份报告写成孤立术语表。
一张可审计的模型账本
报告附录给出的主干配置如下。这里的“激活参数”指单个 token 实际经过的参数量近似值,不等于显存占用,也不能直接换算为一次请求的延迟。
| 项目 | GLM-5 | GLM-4.5 | 解释 |
|---|---|---|---|
| 总参数 / 激活参数 | 744B / 40B | 355B / 32B | 容量增长主要由专家池扩大承担 |
| hidden size | 6144 | 5120 | 残差流宽度 |
| dense / MoE / MTP 层 | 3 / 75 / 1 | 3 / 89 / 1 | MTP 计入参数账本 |
| dense FFN intermediate | 12288 | 12288 | 前部 dense 层的中间维度 |
| expert intermediate | 2048 | 1536 | 单个专家内部宽度 |
| 总专家 / top-k / shared expert | 256 / 8 / 1 | 160 / 8 / 1 | 每个 token 仍只路由到一小部分专家 |
| attention heads | 64 | 96 | MLA-256 配合减少 head 数 |
| QK no-RoPE / RoPE / V head dim | 192 / 64 / 256 | 128 / — / 128 | 附录只列 QK 192;公开配置另列 64 维 RoPE 路径 |
| Q LoRA rank / KV LoRA rank | 2048 / 512 | — | MLA 的低秩潜变量宽度 |
| indexer heads × head dim | 32 × 128 | — | DSA 的候选检索器 |
| vocabulary | 154880 | 151552 | 词表扩展会影响嵌入与输出层 |
报告明确说明,744B / 40B 的统计包含 MTP,却排除了词嵌入和输出层。因此,这组数字适合比较报告内部的架构版本,不应与采用另一种计数口径的模型卡直接相减。另一个容易误读的点是“80 层”:表中的 3 个 dense、75 个 MoE 和 1 个 MTP 描述的是模块构成,不能仅凭加法反推出所有实现中的流水线 stage、共享模块调用次数或计算图深度。
MoE 扩容改变的是容量,不是免费计算
GLM-5 把专家总数从 160 增至 256,把单专家 intermediate 从 1536 增至 2048,而每个 token 的 top-k 仍为 8。直觉上,模型可以在不让每个 token 穿过全部专家的前提下增加参数容量。但实际成本至少有四本账:
- 路由器要为专家打分,并维持负载均衡;
- expert parallel 会产生 all-to-all 通信和 token 重排;
- 744B 权重仍需驻留、分片、加载和保存;
- batch、序列长度与路由偏斜共同决定专家 kernel 的利用率。
所以“40B 激活参数”只回答了单 token 经过多少参数的近似问题,并没有回答端到端 FLOPs、通信字节、显存容量或尾延迟。相关系统路径可继续阅读 MoE 系统 与 模型并行。
MLA、MLA-256 与 Muon Split
MLA 先压缩状态,再恢复多头计算
GQA 会为每个 KV group 保存键和值;MLA 则把历史状态压到低秩潜变量,计算当前 query 时再把潜变量投影到各个 head。报告给出的对比口径是:GLM-5 的 MLA 每个 token 保存 576 维潜在 KV 状态,而其 GQA-8 代理基线保存 2048 维 KV 状态。这个比值说明状态宽度下降,但不是完整显存比,因为真实 KV cache 还包含 dtype、batch、层数、页表与分配碎片。
附录同时给出 KV LoRA rank 512、QK head dim 192、V head dim 256;公开配置进一步把 QK 写成 192 维 no-RoPE 路径与 64 维 RoPE 路径,因此实际 query–key 点积总维度为 256。576 与 512 又属于报告中不同层次的缓存口径;在没有公开实现逐字段说明之前,不应把差值武断命名为某个特定缓存分量。能够确定的是,MLA 的目标是减少逐 token、逐层持久化的状态,而不是取消注意力计算。
为什么普通 Muon 会与 MLA 的多头结构冲突
Muon 对二维参数的更新矩阵做近似正交化,使不同奇异方向的更新尺度更均衡。GLM-4.5 的做法是对多头上投影矩阵整体处理;当不同 head 的梯度统计并不一致时,整体正交化会把它们耦合到同一个矩阵几何中。
Muon Split 的改动很小却很关键:先沿 head 维切分 \(G=[G_1;\ldots;G_h]\),再分别计算
这不是把多头注意力改成互不通信的模型,而只是让优化器按 head 的参数布局处理更新。下面用精确 SVD 写一个慢速语义参考;真实 Muon 通常用 Newton–Schulz 一类迭代近似,不会在每步训练中调用完整 SVD。
import torch
def orthogonalize_rows(x):
    u, _, vh = torch.linalg.svd(x.float(), full_matrices=False)
    return (u @ vh).to(x.dtype)
def muon_split(update, heads):
    if update.ndim != 2 or update.shape[0] % heads:
        raise ValueError("output rows must be divisible by heads")
    return torch.cat([orthogonalize_rows(x) for x in update.chunk(heads, dim=0)])
torch.manual_seed(7)
gradient = torch.randn(4, 3)
split = muon_split(gradient, heads=2)
for head_update in split.chunk(2, dim=0):
    torch.testing.assert_close(
        head_update @ head_update.T,
        torch.eye(2),
        atol=1e-5,
        rtol=1e-5,
    )
assert not torch.allclose(split, orthogonalize_rows(gradient))
最后一个断言刻意展示“先整体正交化”与“先切 head 再正交化”不是同一运算。它不复现 GLM-5 的分布式优化器、缩放规则或精度策略,只固定最容易被写错的布局语义。
MLA-256 是一次 shape 与 kernel 的共设计
报告正文将 MLA-256 描述为把 head dimension 从 192 增至 256,同时将 head 数从 96 减到 64,从而大致保持训练和 prefill 的参数量、计算量,却降低 decode 阶段的总点积与调度成本。附录把 QK head dim 简写为 192、V head dim 写为 256;公开配置则说明 QK 由 192 维 no-RoPE 与 64 维 RoPE 组成,总点积维度同样是 256。因而不能说“QK 仍然只有 192 维”,也不能忽略两条位置路径;可核对的变化是总 head 维度达到 256、V 为 256、head 数降至 64。
这类变换的收益依赖硬件。理论 FLOPs 接近,不代表 kernel 数、张量并行通信、寄存器压力和小 batch decode 延迟也接近。报告用代理模型做了四组对比:
| 方案 | HellaSwag | MMLU | C-Eval | RACE | BBH | GSM8K | HumanEval |
|---|---|---|---|---|---|---|---|
| GQA-8 | 77.3 | 61.2 | 60.0 | 79.6 | 53.3 | 47.6 | 38.5 |
| MLA | 77.3 | 61.5 | 59.7 | 77.8 | 48.9 | 46.2 | 33.5 |
| MLA + Muon Split | 77.8 | 62.5 | 62.1 | 79.9 | 51.8 | 45.0 | 36.7 |
| MLA-256 + Muon Split | 77.4 | 62.0 | 59.9 | 79.6 | 51.3 | 47.5 | 36.6 |
数据支持的结论是:在这组代理训练中,原始 MLA 的质量回落在采用 Muon Split 后显著收窄,MLA-256 又给出相近的综合质量与更友好的推理 shape。数据不支持“MLA-256 在每个任务都更优”,也没有单独证明收益来自某一个变量;这里同时改变了参数布局、优化器处理方式和 head shape。
Shared-parameter MTP:一次参数,多次展开
Multi-Token Prediction 不只预测紧邻的下一个 token,还为更远的未来 token 提供辅助监督。GLM-5 的特殊之处是:训练时把 MTP 计算概念性地展开三次,但三次调用共享同一组参数。于是参数账本仍只有一个 MTP 模块,训练图却获得三个未来位置的信号。
若主模型在位置 \(t\) 的隐藏状态为 \(h_t\),共享模块为 \(f_\phi\),可以把语义写成
参数 \(\phi\) 没有因 \(j\) 增长而复制;激活、临时状态和反向传播路径仍会随展开增加。下面的最小实现只演示共享与 shape,不等价于报告中的完整 Transformer MTP block。
import torch
import torch.nn as nn
class SharedMTP(nn.Module):
    def __init__(self, width, vocab):
        super().__init__()
        self.token = nn.Embedding(vocab, width)
        self.block = nn.Linear(2 * width, width, bias=False)
        self.head = nn.Linear(width, vocab, bias=False)
    def forward(self, hidden, future_ids, steps=3):
        state, logits = hidden, []
        for step in range(steps):
            joined = torch.cat([state, self.token(future_ids[:, step])], dim=-1)
            state = torch.tanh(self.block(joined))
            logits.append(self.head(state))
        return torch.stack(logits, dim=1)
torch.manual_seed(0)
mtp = SharedMTP(width=4, vocab=11)
output = mtp(torch.randn(2, 4), torch.tensor([[1, 2, 3], [3, 2, 1]]))
assert output.shape == (2, 3, 11)
assert sum(p.numel() for p in mtp.parameters()) == 11 * 4 + 8 * 4 + 4 * 11
MTP 还可以充当推测解码的内置 draft head:一次主模型前向提出多个候选,再由目标分布验证。报告在私有 prompt 集、相同四步 speculative setting 下给出平均接受长度 2.76,DeepSeek-V3.2 为 2.55。这是作者报告的有限对比,不包含可独立复现的数据集、端到端吞吐或尾延迟;接受长度更高通常有利于 推测解码,却不能直接等同于固定比例的服务加速。
DSA:在训练末段接入稀疏检索
核心注意力变稀疏,索引器仍然要工作
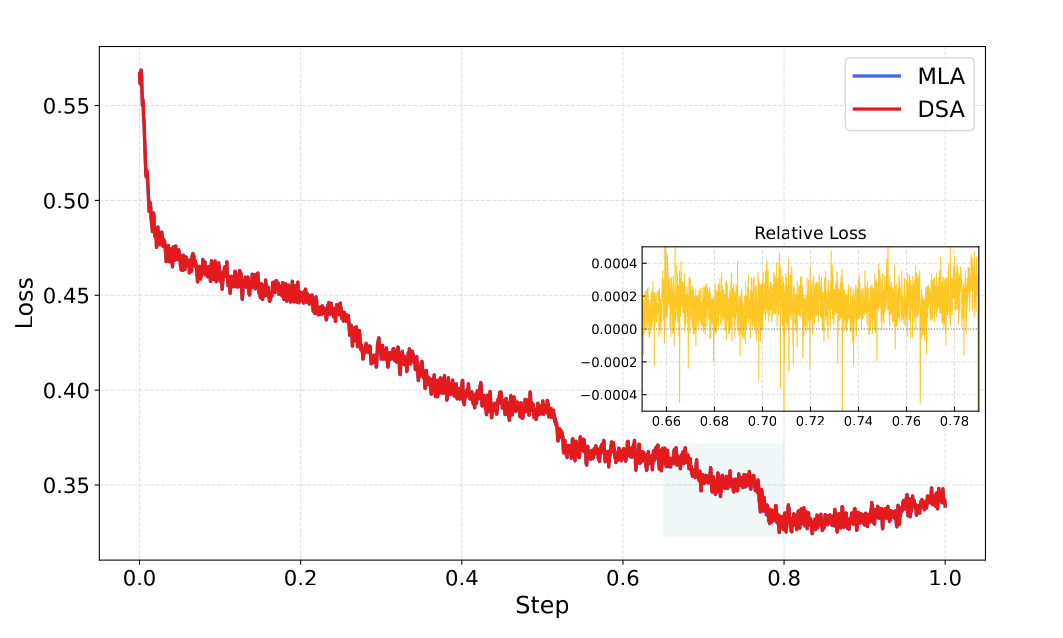
DeepSeek Sparse Attention 为每个 query 先运行轻量 indexer,从长度为 \(L\) 的历史中选出 top-\(k\) 候选,再只对这些 token 做高成本核心注意力。核心部分从 \(O(L^2)\) 变为 \(O(Lk)\);如果每层 indexer 仍扫描所有 query-key 对,它自身依然是 \(O(L^2)\)。因此 DSA 解决了“昂贵 attention value 计算覆盖所有历史”的问题,却没有自动解决“每层都重新寻找候选”的问题,后者正是 IndexCache 的切入点。
GLM-5 并非从训练第一步就启用 DSA,而是在 mid-training 末端从已有模型继续适配:
| 阶段 | 报告披露的设置 | 作用 |
|---|---|---|
| indexer warm-up | 1000 steps;每步 14 条、每条 202752 tokens;学习率从 \(5\times10^{-3}\) 衰减到 \(2\times10^{-4}\) | 让索引器先学会逼近 dense attention 的检索分布 |
| sparse adaptation | 20B tokens;沿用 mid-training 数据与主要超参;常数学习率 \(10^{-5}\) | 让主模型适应被 top-k 截断后的信息路径 |
20B 是 GLM-5 报告中的适配量;GLM-4.7-Flash 的 150B DSA 实验是另一组小模型研究,二者不能拼成同一训练阶段。报告还把 20B 与 DeepSeek-V3.2 披露的 943.7B 适配量对照,说明“后接式稀疏化”可以更省数据,但跨模型、数据与实现的比较不是受控消融。
长上下文结果不是“数学无损”
| 128K 任务 | MLA | DSA |
|---|---|---|
| MQ-NIAH | 100.0 | 100.0 |
| MV-NIAH | 95.5 | 97.0 |
| SQuAD | 79.7 | 86.0 |
| HotpotQA | 66.3 | 63.0 |
这组结果表明,DSA 在所测任务上总体保持了 dense MLA 的长上下文能力,并非每项都提升:HotpotQA 下降 3.3 分。报告估计长序列 attention compute 约下降 1.5–2 倍;这是特定实现与 shape 下的作者测量,不是由 \(O(Lk)\) 直接推出的端到端倍数。top-k 明确丢弃了未选条目,因此也不应把实测接近改写为“稀疏注意力严格等价于 dense attention”。
GLM-4.7-Flash 的独立消融进一步说明只有 warm-up 不够:
| 方案 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
| dense baseline | 97.44 | 96.72 | 95.83 | 92.96 | 85.34 | 79.21 |
| 仅 warm-up | 97.51 | 96.54 | 95.40 | 90.09 | 84.05 | 71.35 |
| 完整 DSA adaptation | 96.77 | 96.25 | 96.69 | 93.45 | 87.06 | 78.86 |
越长的上下文越会放大错误索引的累积影响;让主干经历 sparse adaptation,才有机会学会在受限候选集上重新组织表示。训练阶段的更多背景见 预训练与持续训练,算子侧约束见 注意力内核。
高效注意力消融:没有一条免费的替换路径
报告用一个 40 层、9B 参数、已扩展到 128K 的 GQA 模型比较四类候选:
- SWA interleave:full attention 与 4096-window SWA 按 1:1 交错;
- search-based SWA:用 beam size 8、每轮替换约两层的搜索挑选层模式;
- Gated DeltaNet:把部分 attention 层换成带卷积和显式门控的 recurrent memory;
- SimpleGDN:移除新增卷积与门控参数,直接从已有 Q/K/V 映射到递推状态。
不追加训练时,固定交错 SWA 在长序列上迅速坍塌,而搜索模式保留了更多全局层:
| 方案 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
| full attention | 95.19 | 93.67 | 92.01 | 91.09 | 85.35 | 75.28 |
| 1:1 SWA interleave | 94.87 | 54.02 | 25.89 | 12.61 | 8.32 | 6.51 |
| searched SWA | 95.78 | 92.54 | 88.92 | 82.52 | 70.23 | 53.95 |
这说明局部层与全局层的放置不是只由比例决定:早期特征形成、中段信息搬运和后段读出承担不同角色。搜索能找到更好的无训练初始化,但 128K 仍比 full attention 低 21.33 分,不能替代持续训练。
随后,各种替代结构都在 64K 上继续训练 190B tokens。报告给出的 128K 相对 full attention 变化如下:
| 方案 | RULER | MRCR | HELMET | RepoQA |
|---|---|---|---|---|
| SWA interleave | -30.35 | -6.56 | -13.84 | -26.50 |
| searched SWA | -5.69 | -1.81 | -2.76 | -14.66 |
| Gated DeltaNet | -11.28 | -5.17 | -2.52 | -9.66 |
| SimpleGDN | -8.25 | -4.12 | +4.48 | -7.33 |
SimpleGDN 在 HELMET 上反而高 4.48,却不是其余任务的统一赢家;Gated DeltaNet 在 RepoQA 的回落更小。正确读法不是给四种结构排出一个绝对名次,而是识别它们在检索、长文推理与代码仓库理解上的不同失真。相关递推机制可在 状态空间与线性注意力 继续展开。
为什么最终选择 DSA
综合报告证据,DSA 的优势来自三点:
- 它保留标准注意力的 query-key-value 计算接口,只在候选集合上稀疏化;
- 可以从已训练的 MLA 模型后接适配,不必把所有层替换成新递推结构;
- 在 GLM-5 的 20B-token adaptation 中,长上下文测试总体接近 dense MLA。
代价同样明确:索引器引入新的训练、算子与缓存路径;top-k 是离散选择,必须处理排序、负载与 kernel 稀疏访问;逐层索引仍可能成为长上下文瓶颈。也正因为最后一点,GLM-5.2 才进一步采用跨层 index sharing,详见 IndexCache 与 IndexShare。
如何阅读这些数字
可以较有把握地确认的事实包括模型 shape、两阶段 DSA 适配预算、报告表格中的代理评测,以及 private prompt set 上披露的 MTP 接受长度。由这些事实可以合理推断,GLM-5 的设计中心是“容量、状态、候选集合和未来 token”四种维度的联合稀疏化。
仍然未知或不能从报告单独推出的部分包括:
- 744B 模型每个模块的精确参数逐项分解与所有并行切分;
- MLA 的 576 维缓存口径在公开 serving 实现中的逐字段布局;
- Muon Split 在相同数据、相同算力下相对 AdamW 的独立大模型消融;
- shared MTP 在公开 prompt 集上的接受长度分布、拒绝位置与端到端延迟;
- DSA、SWA、GDN 在相同 kernel 成熟度和服务栈下的成本曲线。
因此,架构报告最适合用于建立假设和复现清单,而不是把单一表格外推成普遍规律。一个完整复现至少要同时报告质量、训练 tokens、参数计数口径、KV / index 状态字节、prefill 与 decode 的 batch/length、kernel 版本及硬件拓扑。
Reference
- GLM-5 Technical Report:完整架构、训练与评测披露
- GLM-5 官方代码仓库与模型入口
- GLM-4.5 Technical Report:GLM-5 架构演进的直接前序
- Muon is Scalable for LLM Training:大规模 Muon 的缩放与实现
- Better & Faster Large Language Models via Multi-token Prediction:MTP 原始工作
- DeepSeek-V3.2:DeepSeek Sparse Attention 与持续训练路径
- IndexCache:跨层复用 DSA 索引
- Gated Delta Networks:门控 delta rule 与混合架构
- RULER:长上下文模型的合成长程能力评测
- Fast Inference from Transformers via Speculative Decoding:推测解码的经典形式